Příklad 0.2 (Odvození Catalanova čísla). Mějme funkci:
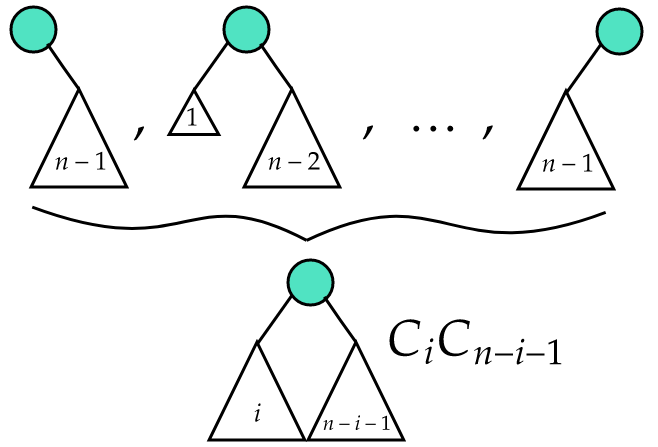
Dostáváme tak: , což si můžeme zapsat jako kvadratickou rovnici: Počítáme tak dál a vyjádříme vzorec pro -tý člen:
2026-09-25
Státnice – Obecná Informatika
(Snad budoucí Bc.) Karel Velička
2026-09-25
Tento dokument obsahuje teoretickou přípravu na státnice z Obecné informatiky na MFF UK pro rok 2024/25. Snažil jsem se, jak jen to šlo, dodržet strukturu zveřejněných požadavků. Valná většina uvedeného textu je z mých poznámek, které jsem si v průběhu studia udělal. Výjimkou jsou Logika, ADS a TeMno, kde jsem čerpal přímo z materiálů vyučujících (resp. spolužáka).
Další zdroje a veškeré, mnou sepsané poznámky za roky Bc. studia, jsou k dispozici zde.
P.S. Za nic neručím. Určitě se tu nějaké chyby najdou.
Z následujících témat budou vybrána .
Definice 0.1 (Reálná posloupnost). Reálná posloupnost je funkce .
Definice 0.2 (Limita posloupnosti). Nechť je reálná posloupnost a , kde je spolu s . Potom je limita posloupnosti , pokud: Píšeme .
Definice 0.3 (Nevlastní limita posloupnosti). Pokud , pak konverguje a mluvíme o limitě vlastní, pokud , pak diveguje a mluvíme o limitě nevlastní.
Definice 0.4 (Podposloupnost). je podposloupností posloupnosti , pokud existuje taková posloupnost kde . Značíme jako .
Definice 0.5 (Hromadný bod). Hromadný bod posloupnosti , pokud je limitou nějaké podposloupnosti posloupnosti .
Věta 0.1 (Bolzano-Weierstrass). Každá omezená
reálná posloupnost má konvergentní podposloupnost.
Omezená monotónní posloupnost má vlastní limitu.
Věta 0.2 (Aritmetika limit). Nechť jsou posloupnosti reálných čísel s , . Potom, pokud jsou výrazy na pravých stranách definovány, platí
,
,
, pokud pro každé .
Věta 0.3 (O dvou policajtech). Nechť posloupnosti , , splňují, že a . Pak konverguje a .
Užitečné vztahy pro větu o dvou policajtech
Věta 0.4 (O limitě a uspořádání). Nechť posloupnosti mají limity a . Potom:
platí ,
.
Definice 0.6 (Řada). Řada je posloupnost .
Definice 0.7 (Částečný součet řady). Částečný součet řady je
Definice 0.8 (Součet řady). Součet řady je limita .
Definice 0.9 (Geometrická řada). Geometrická řada je řada , kde je kvocient.
Definice 0.10 (Součet geometrické řady).
Definice 0.11 (Absolutně konvergentní řada). Řada je absolutně konvergentní, pokud konverguje řada .
Definice 0.12 (Harmonická řada). Harmonickou řadu definujeme jako , kde . Platí, že konverguje, pokud , jinak diverguje.
Věta 0.5 (Leibnitzovo kritérium). Pokud pro řadu platí, že posloupnost je kladná, klesající a má limitu , pak řada konverguje.
.
Definice 0.13 (Okolí bodu). -okolí bodu , kde je interval
Definice 0.14 (Prstencové okolí bodu). Prstencové okolí bodu .
Definice 0.15 (Limita funkce v bodě). Funkce má v bodě limitu , když
Definice 0.16 (Jednostranná limita funkce). Podobně, jen
Důležité limitní vztahy.
Věta 0.6 (Vztah limit funkce s uspořádáním). Nechť a funkce jsou definované na nějakém prstencovém okolí bodu .
Mají-li funkce v bodě limitu a , pak takové, že pro každé . (Limita zachovává ostré nerovnosti.)
Existuje-li pro každé , a mají-li funkce limitu v bodě , potom . (Limita zachovává neostré nerovnosti.)
Existuje-li pro každé a , potom i . (O dvou policajtech.)
Věta 0.7 (Heine). Limita funkce pro každou posloupnost splňující a , platí .
Definice 0.17 (Spojitost funkce v bodě). Funkce je spojitá v bodě , pokud Neboli funkce je v bodě spojitá, pokud .
Definice 0.18 (Limita složené funkce). Nechť a nechť funkce mají limity a . Složená funkce má potom limitu platí jedna z podmínek:
je spojitá v ,
, tedy na nějakém prstencovém okolí funkce nenabývá hodnotu .
Definice 0.19 (Spojitost na intervalu). Funkce je spojitá na intervalu, je-li spojitá v každém vnitřním bodu a jednostraně spojitá v mezích.
Věta 0.8 (Nabývání mezihodnot). Funkce spojitá na intervalu nabývá všech hodnot mezi mezemi intervalu. Tedy pro ; ; je spojitá a , pak .
Definice 0.20 (Maximum). Nechť a . Řekneme, že funkce v bodě nabývá svého maxima, když . (minimum analogicky, jen opačná nerovnost).
Věta 0.9 (Princip minima a maxima). Nechť a je spojitá funkce. Potom nabývá na intervalu svého maxima i minima.
Definice 0.21 (Derivace funkce). Nechť bod je limitní bod množiny a je funkce. Potom derivace v bodě je limita
Definice 0.22 (Diferencovatelnost). Jestliže má v bodě vlastní derivaci, říkáme, že je v diferencovatelná. (Diferencovatelnost spojitost).
Věta 0.10 (Derivace složené funkce (řetízkové pravidlo)). Nechť funkce a má spojitou derivaci v :
| Pravidlo | Vzorec |
|---|---|
| Derivace součtu | |
| Derivace násobku | |
| Leibnizovo pravidlo (součin) | |
| Derivace podílu | |
| Elementární funkce | Derivace |
| Mocninná funkce | |
| Exponenciální funkce | , |
| Logaritmická funkce | , |
| Goniometrické funkce | |
Věta 0.11 (l’Hospitalovo pravidlo). Nechť
mají vlastní derivace,
a
nebo
,
potom:
Věta platí i pro
a pro
.
Definice 0.23 (Taylorův polynom funkce). Nechť a . Potom Taylorův polynom funkce řádu se středem v bodě je
Věta 0.12 (Taylorova řada funkce). Má-li funkce v bodě derivace všech řádů, rozumíme pro její Taylorovou řadou se středem v řadu
| Funkce | Taylorův polynom | Konvergence |
|---|---|---|
| Exponenciální | ||
| Sinus | ||
| Kosinus | ||
| Přirozený logaritmus |
Určíme definiční obor, speciální tvar (sudost/lichost/periodicita), limity krajních bodů, 1. derivace, extrémy a monotonie, 2. derivace, inflexní body a kon[vex/kav]ita, asymptoty, náčrt.
Věta 0.13 (Lagrangeova). Pokud je spojitá funkce, pak .
Definice 0.24 (Extrémy a monotonie). Nechť má první derivaci, potom pokud
, pak je podezřelá z extrému,
, pak roste (resp. klesá).
Definice 0.25 (Konvexita/ Konkavita). Nechť má druhou derivaci, potom pokud , pak je konvexní a pokud , pak je konkávní.
Definice 0.26 (Inflexní bod). Inflexní bod je bod, ve kterém a nebo neexistuje. (Dochází ke změně směru funkce).
Definice 0.27 (Primitivní funkce). Nechť je netriviální interval a . Potom je primitivní funkce k , neboli , pokud na celém .
Definice 0.28 (Metody výpočtu: Substituce). Funkce spojité na intervalu .
Definice 0.29 (Metody výpočtu: Per partes). Funkce spojité na intervalu .
| Elementární funkce | Neurčitý integrál (bez konst. ) |
|---|---|
| Mocninná funkce | |
| Exponenciální funkce | , |
| Logaritmická funkce | |
| Goniometrické funkce | |
| Goniometrické funkce složitější | |
Definice 0.30 (Newtonův integrál funkce). Newtonův integrál funkce na intervalu , :
Definice 0.31 (Dělení). Rozdělení intervalu je posloupnost , kde:
Definice 0.32 (Horní/dolní Riemannův součet). Pro omezenou funkci a rozklad definujeme dolní a horní součty: kde
Definice 0.33 (Horní/dolní Riemannův integrál). Horní a dolní Riemannův integrál přes je:
Definice 0.34 (Riemannův integrál funkce). Riemannův integrál funkce přes je
Věta 0.14 (Základní věta analýzy 1). 1 Pro Riemannovsky integrovatelnou a primitivní je a platí, že
je spojitá na a
v každém bodě spojitosti funkce existuje .
Věta 0.15 (Základní věta analýzy 2). Pokud je Newtonovsky i Riemannovsky integrovatelná, pak
Věta 0.16 (Odhady součtu řad). Pro neklesajicí (resp. nerostoucí) na intervalu platí Pro neklesajicí (resp. nerostoucí) funkci na intervalu platí
Věta 0.17 (Obsahy rovinných útvarů). Plocha mezi dvěma funkcemi a :
Věta 0.18 (Délka křivky). Pro graf funkce :
Věta 0.19 (Objem rotačního tělesa). Zvlášť pro objem a povrch rotačního tělesa:
Objem vzniklý rotací kolem osy :
Povrch rotační plochy:
Definice 0.35 (Grupa). Grupa je dvojice , kde je nosná množina, na které je definována binární operace , splňující:
, …asociativita
, …existence neutrálního prvku
. …existence inverzního prvku
Pokud platí navíc ještě komutativita, jedná se o Abelovskou grupu.
Definice 0.36 (Podgrupa). Nechť a jsou grupy, potom je podgrupa grupy , značeno , pokud: a pokud jsou zachovány inverzní a neutrální prvky.
Definice 0.37 (Permutace). Permutace na množině je bijekce .
Definice 0.38 (Inverze v permutaci). Inverze v permutaci je dvojice prvků taková, že: a .
Definice 0.39 (Znaménko permutace). Znaménko permutace je číslo . Ekvivalentně také jako , kde je délka cyklu .
Definice 0.40 (Těleso). Nechť je množina a jsou binární operace na . Trojici potom nazýváme tělesem, splňuje-li:
tvoří Abelovskou grupu s neutrálním prvkem ,
tvoří Abelovskou grupu s neutrálním prvkem ,
platí distributivita, tedy .
Definice 0.41 (Charakteristika tělesa). Pokud t.ž v tělese platí , potom nejmenší takové je tělesa . Jinak má těleso charakteristiku .
Definice 0.42 (Konečná tělesa). Konečné těleso (GF) značíme , kde , je prvočíslo a .
Definice 0.43 (Maticový zápis). Pro soustavu , kde je matice soustavy, je vektor neznámých a je vektor pravých stran, je rozšířená matice soustavy:
Definice 0.44 (Elementární řádkové úpravy). Vznikne z matice matice ():
vynásobením i-tého řádku ,
přičtením -tého řádku k -tému, když ,
přičtení t-násobku j-tého řádku k i-tému, když ,
prohození dvou řádků.
Definice 0.45 (Odstupňovaný tvar matice (REF)).
Matice
je v REF, pokud (a) nenulové řádky jsou
seřazeny podle počáteřních nul a (b) nulové řádky jsou
pod nenulovými.
Matice je v RREF, pokud je v REF, pivoty jsou jednotkové a nad
i pod pivoty jsou pouze nuly.
Definice 0.46 (Pivot). Pivot je první nenulový prvek na -tém řádku.
Seřaď řádky podle počtu počátečních nul.
Pokud mají dva nenulové řádky stejný počet počátečních nul
(-tý
a
-ní),
tak od
-ního
odečteme
-násobek
-tého.
Opakuj, dokud nemají každé dva nenulové řádky různé počty počátečních
nul.
Algoritmus je konečný, protože po kroku 2. vždy vzroste celkový počet počátečních alespoň o .
Seřaď řádky podle počtu počátečních nul.
Opakuj, dokud není matice REF.
Algoritmus je konečný, protože v každé iteraci se buď zvýší počet počátečních nul, nebo se pivotní prvek přesune blíže k diagonále.
Věta 0.20 (Frobeniova). Soustava má řešení se rovná hodnosti rozšířené matice.
| Počet řešení | Podmínka |
|---|---|
| Žádné | Existuje řádek , |
| Právě jedno | # pivotů # neznámých, žádné konflikty |
| Nekonečně mnoho | # pivotů # neznámých, žádné konflikty |
Definice 0.47 (Jednotková matice). Pro je jednotková matice definována vztahy:
Definice 0.48 (Transponovaná matice). Transponovaná matice k matici je taková matice , pro kterou platí:
Definice 0.49 (Symetrická matice). Symetrická matice je taková čtvercová matice , že:
Definice 0.50 (Inverzní matice). Inverzní matice k čtvercové matici je taková matice , pro kterou platí:
Definice 0.51 (Regulární matice). Regulární
matice je čtvercová matice, ke které existuje inverzní
matice.
Ekvivalentně, pokud je
.
Ekvivalentně, pokud
má pouze triviální řešení
.
Ekvivalentně, pokud
.
Ekvivalentně, pokud její sloupce nebo řádky jsou lineárně
nezávislé.
Ekvivalentně, pokud žádné vlastní číslo není nulové.
Definice 0.52 (Singulární matice). Singulární matice je taková matice, která není regulární.
Definice 0.53 (Rovnost matic). Dvě matice se rovnají, , pokud mají stejné rozměry a
Definice 0.54 (Součet Matic). Bud’ . Pak je matice typu s prvky
Definice 0.55 (Maticový součin). Pro součin dvou matic a platí :
Definice 0.56 (Hodnost matice). Hodnost matice , značená jako , je počet pivotů v libovolné matici v REF takové, že . Tedy počet lineárně nezávislých řádků.
Definice 0.57 (Vektorový prostor). Vektorový prostor nad tělesem je množina spolu s binární operací na a binární operací skalárního násobku , kde:
tvoří Abelovskou grupu,
, (kde 1 je neutrální prvek pro násobení v )
, …asociatavita
, …distributivita
, …distributivita
Prvky se nazývají skaláry a prvky vektory.
Definice 0.58 (Podprostor vektorového prostoru). Podprostor vektorového prostoru je neprázdná podmnožina , splňující uzavřenost na operaci a obsahující nulový vektor.
Definice 0.59 (Lineární kombinace). Lineární kombinace vektorů nad je libovolný vektor , kde .
Definice 0.60 (Lineární obal). Lineární obal množiny , kde je vektorový prostor nad , je průnik všech podprostorů z obsahující . Tedy množina všech jejích lineárních kombinací.
Definice 0.61 (Lineární nezávislost). Množina
vektorů
ve vektorovém prostoru
je lineárně nezávislá, pokud nelze nulový vektor získat
netriviální lineární kombinací vektorů z
.
Tedy, vektory
jsou LN
má pouze triviální řešení
.
Definice 0.62 (Báze). Báze vektorového prostoru je LN množina , která generuje , .
Definice 0.63 (Dimenze). Dimenze vektorového prostoru , , je mohutnost jeho (konečné) báze.
Definice 0.64 (Jádro). Jádro matice je podprostor tvořen řešeními soustavy . Platí vztah: .
Definice 0.65 (Řádkový prostor). Řádkový
prostor matice je prostor generovaný jejími řádky.
Pro matici
:
Řádkový prostor je kolmý
na jádro, tedy
.
Dále také
.
Definice 0.66 (Sloupcový prostor). Sloupcový
prostor matice je prostor generovaný jejími sloupci.
Pro matici
:
Platí vztah:
.
Definice 0.67 (Vektor souřadnic). Nechť je konečná uspořádaná báze vektorového prostoru nad tělesem . Vektor souřadnic vzhledem k bázi je , kde . Neboli, obsahuje v koeficienty LK bázických vektorů , která tvoří .
Věta 0.21 (Steinitzova o výměně). Nechť je konečná LN množina vektorového prostoru nad a je systém generátorů , tedy . Potom platí a existuje , taková že:
Definice 0.68 (Lineární zobrazení). Nechť a jsou vektorové prostory nad stejným tělesem . Potom zobrazení se nazývá lineární zobrazení, pokud splňuje:
Maticová reprezentace LZ pro matici a vektor je .
Definice 0.69 (Matice lineárního zobrazení). Nechť a jsou vektorové prostory nad stejným tělesem s bázemi . Matice lineárního zobrazení vzhledem k bázím a je , jejíž sloupce jsou vektory souřadnic obrazů vektorů báze vzhledem k bázi . Neboli,
Definice 0.70 (Matice složeného zobrazení). Pokud máme zobrazení a , pak matice složeného zobrazení je součinem jejich matic: .
Definice 0.71 (Jádro lineárního zobrazení). Jádro lineárního zobrazení je
Definice 0.72 (Isomorfismus). Isomorfismus prostorů a je bijektivní lineární zobrazení .
Věta 0.22. Dva prostory nad stejným tělesem jsou isomorfní mají stejnou dimenzi.
Definice 0.73 (Skalární součin). Skalární součin na vektorovém prostoru nad je zobrazení, které přiřadí každé dvojici vektorů skalár tak, že jsou splněny následující axiomy:
, rovnost pokud , …pozitivní definitnost
, (komplexně sdružené) … v
,
.
Definice 0.74 (Norma indukovaná skalárním součinem). Nechť je prosor se skalárním součinem nad nebo , pak norma odvozená ze skalárního součinu je zobrazení přiřazující vektoru jeho normu .
Věta 0.23 (Pythagorova). Pokud je VP nad a jsou kolmé, tak .
Věta 0.24 (Cauchy-Schwartzova nerovnost). Pro skalární součin libovolných2 dvou vektorů a ve vektorovém prostoru nad platí:
Věta 0.25 (Trojúhelníková nerovnost). Každá norma odvozená ze skalárního součinu splňuje:
Definice 0.75 (Ortogonální (kolmé) vektory). Vektory z prostoru se skalárním součinem jsou ortogonální, , pokud .
Definice 0.76 (Ortogonální a ortonormální báze). Báze prostoru se skalárním součinem je ortogonální, pokud pro každé . Pokud navíc , pak je ortonormální.
Definice 0.77 (Fourierovy koeficienty). Nechť je ortonormální báze prostoru . Pro každé platí: . Koeficienty se nazývají Fourierovy.
Definice 0.78 (Ortogonální doplněk). Ortogonální doplněk podmnožiny prostoru se skalárním součinem je .
Věta 0.26. Pro konečně generovaný prostor se skalárním součinem a podprostor platí:
Definice 0.79 (Ortogonální projekce). Nechť je prostor se skalárním součinem a je jeho podprostor s ortonormální bází . Potom ortogonální projekce na je zobrazení definované jako .
Definice 0.80 (Vzdálenost bodu od podprostoru). Vzdálenost vektoru od podprostoru rovna normě rozdílu .
Poznámka 0.1. Ortogonální projekce je lineární zobrazení.
Definice 0.81 (Ortogonální matice). Matice je ortogonální, pokud . Pro ortogonální matici tedy platí .
Věta 0.27 (Vlastnosti ortogonálních matic). Matice je ortogonální, právě když sloupce tvoří ortonormální bázi . Součin ortogonálních matic je ortogonální matice. Dále platí vztahy:
Definice 0.82 (Determinant). Determinant matice je dán výrazem: Můžeme prohazovat řádky i sloupce, ale změní se tím znaménko determinantu.
Věta 0.28. Pro horní trojúhelníkové matice je determinant roven součinu na diagonále.
Věta 0.29 (Linearita determinantu). Determinant matice je lineárně závislý na každém jejím řádku i sloupci. Tedy vzhledem ke sčítání řádků a násobení řádku skalárem. Platí .
Věta 0.30 (Multiplikativnost determinantu). Pro libovolné .
Důsledek 0.1. Platí .
Definice 0.83 (Adjungovaná matice). Pro matici je adjungovaná matice definována vztahem
Věta 0.31 (Laplaceův rozvoj). Nechť je podmatice získaná z odstaněním -tého řádku a -tého sloupce, potom pro libovolné a jakékoli platí, že:
Poznámka 0.2 (Geometrická reprezentace determinantu). Absolutní hodnota determinantu rozhoduje, zda se daná plocha geometrického útvaru proměňuje.
zvětšuje se,
zmenšuje se,
zachová se,
zkolabuje na menší dimenzi (je singulární).
Definice 0.84 (Vlastní číslo). Nechť je vektorový prostor nad a je lineární zobrazení , potom vlastní číslo zobrazení je jakékoli , pro které existuje vektor , t.ž.: .
Definice 0.85 (Vlastní vektor). Nechť je vlastní číslo, potom jemu odpovídající vlastní vektor je libovolný vektor , t.ž.: . Také, pokud .
Definice 0.86 (Vlastní číslo a Vlastní vektor matice). Jestliže má konečnou dimenzi , pak může být reprezentováno maticí vzhledem k nějaké bázi prostoru . Vlastní číslo matice je potom a vlastní vektor matice , oba splňující .
Věta 0.32. Vlastní vektory odpovídající stejnému vlastnímu číslu tvoří podprostor.
Věta 0.33. Nechť je lineární zobrazení a jsou různá vlastní čísla a odpovídající netriviální vlastní vektory. Potom jsou lineárně nezávislé.
Poznámka 0.3. Platí, že matice je než počet nenulových vlastních čísel.
Poznámka 0.4. V každé matici řádu je nejvýše vlastních čísel.
Věta 0.34 (Vlastnosti vlastních čísel). Nechť má vlastní čísla a jim odpovídající vlastní vektory . Pak:
je regulární není její vlastní číslo,
,
,
je-li regulární, pak má vlastní čísla a vlastní vektory ,
má vlastní čísla a vlastní vektory ,
má vlastní čísla a vlastní vektory ,
má vlastní čísla a vlastní vektory ,
má vlastní čísla , ale vlastní vektory obecně jiné.
Definice 0.87 (Charakteristický polynom). Charakteristický polynom je .
Věta 0.35. Číslo je vlastním číslem matice je kořenem charakteristického polynomu . Tedy když .
Definice 0.88 (Algebraická násobnost). Algebraická násobnost vlastního čísla je násobnost jako kořene charakteristického polynomu .
Definice 0.89 (Geometrická násobnost). Geometrická násobnost vlastního čísla je dimenze (pod)prostoru jeho vlastních vektorů. Tedy je rovna .
Definice 0.90 (Podobné matice). Matice jsou si podobné, pokud existuje regulární matice taková, že . (Vlastní čísla matice vlastní čísla matice .)
Věta 0.36. Matice je podobná diagonální prostor má bázi z vlastních vektorů .
Definice 0.91 (Diagonalizovatelná matice).
Matice podobná diagonální matici je
diagonalizovatelná.
Matice
s navzájem různými vlastními čísly je vždy diagonalizovatelná.
Věta 0.37. Matice je diagonalizovatelná algebraická násobnost se rovná geometrické násobnosti pro každé její vlastní číslo.
Věta 0.38. Pro jakoukoli symetrickou matici s existuje regulární matice taková, že je diagonální.
Definice 0.92 (Spektrální rozklad). Diagonalizovatelná matice lze vyjádřit ve tvaru , kde je regulární a je diagonální.
Věta 0.39 (Spektrální rozklad symetrických matic). Pro každou symetrickou matici existuje ortogonální a diagonální takové, že .
Definice 0.93 (Positivně definitní matice). Pokud symetrická splňuje pak je matice pozitivně definitní. Je semidefinitní, pokud platí .
Věta 0.40 (Vlastnosti positivně definitních matic). Nechť jsou positivně definitní matice. Pak platí:
je positivně definitní matice,
Pro libovolné je positivně definitní matice,
Je-li positivně definitní, pak je regulární a je též positivně definitní.
Věta 0.41 (Charakterizace PD). Pro symetrickou matici jsou následující podmínky ekvivalentní:
je pozitivně definitivní
má všechna vlastní čásla kladná (resp. nezáporná pro semi)
Existuje regulární matice , t.ž.: .
Věta 0.42 (Choleskeho rozklad3). Pro každou pozitivně definitní matici existuje unikátní horní trojúhelníková matice s kladnou diagonálou, t.ž.: . Matice se nazývá Choleského rozklad.
Věta 0.43 (Sylvestrovo kritérium). Symetrická je positivně definitní determinanty hlavních vedoucích podmatic jsou kladné.
Definice 0.94 (Relace mezi množinami). Relace je podmnožina kartézského součinu dvou množin a . Relace na množině je .
Definice 0.95 (Vlastnosti binárních relací). Pro relaci na definujeme:
Reflexivita: .
Symetrie: .
Antisymetrie: .
Transitivita: .
Definice 0.96 (Ekvivalence). Relace na je ekvivalentní je reflexivní, symetrická a tranzitivní.
Definice 0.97 (Ekvivalenční třída). Ekvivalenční třídu definujeme jako .
Poznámka 0.5 (Bellova čísla). Počet ekvivalencí na prvcích udává Bellovo číslo
Definice 0.98 (Uspořádání). Relace na je uspořádání je reflexivní, antisymetrická a tranzitivní. Dále je uspořádání
lineární . Neboli, prvky jsou porovnatelné (=trichomické).
částečné není lineární. (Částečně uspořádaná množina = ČUM)
ostré je ireflexivní.
Definice 0.99 (Maximální a největší prvek). Nechť je ČUM. Potom je
maximální prvek, pokud . (resp. minimální ).
největší prvek, pokud . (resp. nejmenší ).
Definice 0.100 (Řetězec a antiřetězec). Nechť je ČUM a , potom pro:
Řetězec platí, že jsou porovnatelné.
Antiřetězec platí, že , které jsou různé a porovnatelné.
Definice 0.101 (Výška uspořádání). Výška uspořádání je maximální velikost řetězce v uspořádání.
Definice 0.102 (Šířka uspořádání). Šířka uspořádání je maximální velikost antiřetězce v uspořádání.
Věta 0.44 (O dlouhém a širokém). Nechť je konečná ČUM, potom
Definice 0.103 (Funkce). Funkce je relace taková, že .
Definice 0.104 (Prosté/injektivní zobrazení). Funkce je prostá pro všechna existuje nejvýše jedno . ().
Definice 0.105 (Na/surjektivní zobrazení). Funkce je na pro všechna existuje alespoň jedno . ().
Definice 0.106 (Bijekce). Funkce je bijektivní je prostá i na.
Věta 0.45 (Počet funkcí). Nechť a jsou dvě množiny, potom počet funkcí mezi a je .
Věta 0.46 (Počet prostých funkcí). Potom počet prostých funkcí mezi a je .
Věta 0.47. Počet všech -prvkových podmnožin je roven , tedy .
Definice 0.107 (Permutace). Permutace je bijekce .
Definice 0.108 (Pevný bod). Pro permutaci a prvek je pevný bod . Zobrazí se sám na sebe.
Věta 0.48. Pokud , , je konečná množina, pak permutace je bijekce z do , tedy .
Definice 0.109 (Množina všech -prvkových podmnožin). Nechť je množina. Potom je množina všech -prvkových podmnožin množiny :
Definice 0.110 (Kombinační číslo). Pro čísla platí:
Věta 0.49. Počet uspořádaných -tic bez opakování a -prvkových podmnožin je roven .
Věta 0.50 (Vlastnosti kombinačních čísel).
Věta 0.51 (Binomická).
Věta 0.52 (Princip inkluze a exkluze). Pro konečné množiny platí:
Proof. Nechť
Levá i pravá strana jsou součty velikostí nějakých množin, takže se
můžeme ptát, kolikrát levé a pravé straně přispěje každý prvek
.
Víme, že k levé přispěje jednou, chceme dokázat, že k pravé také jednou.
Předpokládejme, že je
v
množinách z
,
pak 1. suma je
,
počítáme
-krát,
2. suma
počátáme
-krát,
atd. Celkem
Dále z binomické věty víme, že
.
A jelikož
,
tak
,
tedy
.
Pravá strana tak také přispěje právě jednou. ◻
(Problém šatnářky). Do divadla přišlo
pánů s
klobouky, každý pán si odložil klobouk v šatně a po představení si jej
zase vyzvedl. Šatnářka však pánům vybrala klobouky náhodně. Jaká je
pravděpodobnost, že žádný pán nedostal svůj klobouk?
Pravděpodobnost, že žádný pán nedostane svůj klobouk je
.
Víme, že # počet permutací
.
Nejprve spočítáme #počet permutací s pevným bodem. Pro každý prvek
definujeme
(permutace s pevným bodem
).
Pak platí, že
,
a když se podíváme na velikost průniku množin
,
tak je to
.
Z PIE:
Dosadíme do počtu permutací bez pevného bodu:
Pravděpodobnost, že žádný pán nedostal svůj klobouk je tedy
.
Věta 0.53 (Počet surjekcí). Počet surjekcí je .
Proof. Máme množiny , a , . Počet surjekcí určíme za pomoci PIE. Víme, že počet všech funkcí mezi množinami je . Když z množiny odebereme jeden prvek, dostaneme , když odebereme dva, dostaneme atd. Obecně nám to pro odebraných prvků dává .
Dále chceme počítat jen čistě surjektivní zobrazení, nikoliv bijektivní, které nastane v případě . Konkrétně: Nechť a nechť je počet tohoto zobrazení. Množinu rozdělíme do částí , kde pro každou tuto část existuje přiřazení do množiny . Nastává tedy bijekce z do , kde počet bijektivních zobrazení odpovídá . Celkem bychom dostali "počet ", kde je zbylá (námi hledaná) funkce na. ◻
Definice 0.111 (Eulerova funkce). Zobrazení značí pro počet čísel nesoudělných s číslem . Tedy jinak .
Nechť je rozklad na prvočinitele. Aplikujeme PIE: Počet čísel nesoudělných s získáme odečtením počtů násobků všech prvočísel a přičtením zpět násobků jejich dvojic atd.: Nakonec vytkneme a tím získáme:
Definice 0.112 (Párování). Párování v grafu je množina , t.ž. každý vrchol je incidentní nejvýše jednou hranou z .
Definice 0.113 (Vrcholové prokrytí). Vrcholové prokrytí v grafu je množina vrcholů , t.ž. každá hrana obsahuje alespoň jeden vrchol z .
Definice 0.114 (Systém různých reprezentantů). SRR v hypergrafu je funkce , t.ž.:
, kde je reprezentant hyperhrany ,
, tedy funkce je prostá (zástupe se neopakuje).
(Máme několik množin a z každé chceme vybrat zástupce, aby se neopakoval)
Věta 0.54 (König-Egerváty). V každém bipartitním grafu má největší párování stejnou velikost, jako nejmenší vrcholové pokrytí.
Věta 0.55 (Hallova bipartitní). Nechť je bipartitní graf. Potom má párování velikosti
Proof. Musím dokázat obě implikace.
Pokud existuje párování velikosti , tak pro každou existuje vrcholů spárovaných s a ty patří do . Tedy .
Pro spor. Nechť je největší párování , t.ž.: . Existuje pokrytí , kde . Definujeme si , a .
Jelikož všechny hrany z musí vést do , jinak není pokrytí, tak platí . Máme tedy , což nám dává spor.
◻
Důsledek 0.2. Pokud platí , pak má perfektní párování.
Věta 0.56 (Hallova - hypergrafová verze). Hypergraf má SRR .
Proof. Nechť
je hypergraf a
jeho graf incidence.
má SRR
má párování velikosti
.
Hallova podmínka pro
bipartitní Hallova podmínka pro
a partitu
.
Ekvivalence platí díky bipartitní Hallově podmínce. ◻
(Nalezení SRR v polynomiálním čase). Modelujeme bipartitní graf. Levá partita jsou množiny . Pravá partita prvky . Hrana vede z , pokud . Najdeme max párování v bipartitním grafu (třeba Ford-Fulkerson – polytime) a z Hallovy věty: SRR existuje párování pokrývá všechny množiny .
Definice 0.115 (Graf). Graf je uspořádaná dvojice , kde je konečná neprázdná množina vrcholů a konečná neprázdná množina hran, neboli všech dvouprvkovych podmnožin .
Definice 0.116 (Isomorfismus grafů). Grafy a jsou isomorfní, pokud existuje bijekce mezi vrcholy:
Definice 0.117 (Podgraf). Graf je podgrafem grafu , pokud a .
Definice 0.118 (Indukovaný podgraf). Podgraf je indukovaný, pokud . Tedy bereme všechny původní hrany grafu .
Definice 0.119 (Stupeň vrcholu). Stupeň vrcholu v grafu je Neboli počet hran grafu , které obsahují hranu s .
Definice 0.120 (-regulární graf). Graf je -regulární, pokud pro platí .
Definice 0.121 (Skóre grafu). Skóre grafu je posloupnost stupňů všech vrcholů (krom uspořádání).
Definice 0.122 (Doplněk grafu). Doplněk grafu je graf .
Definice 0.123 (Úplný graf). Úplný graf na vrcholech značíme , kde a .
Definice 0.124 (Bipartitní graf). Graf
je bipartitní, pokud lze
rozdělit na dvě disjunktní množiny
a
takové, že každá hrana z
obsahuje jeden bod z
a druhý z
.
Tedy pokud
,
t.ž.
.
Hrany jsou mezi
a
,
neboli
.
Definice 0.125 (Úplný bipartitní graf). Úplný bipartitní graf na vrcholech značíme , kde (=dvě partity) a .
Definice 0.126 (Eulerovský graf). Graf je Eulerovský je souvislý a všechny vrcholy mají sudý stupeň.
Definice 0.127 (Cesta). Cestu na vrcholech značíme , kde a .
Definice 0.128 (Kružnice). Kružnici na vrcholech značíme , kde a
Definice 0.129 (Sled). Sled z
do
v grafu
je posloupnost
,
pokud
platí
,
kde
jsou vrcholy a
hrany.
(Mohou se opakovat vrcholy i hrany).
Definice 0.130 (Tah). Tah z
do
v grafu
je posloupnost
,
pokud
platí
,
kde
jsou vrcholy a
navzájem různé hrany.
(Mohou se opakovat pouze vrcholy, ne hrany).
Definice 0.131 (Souvislý graf). Graf je souvislý, pokud existuje cesta z do .
Definice 0.132 (Relace dosažitelnosti (ekvivalence)). Ekvivalence v grafu je binární relace na , t.ž. , pokud existuje cesta z do .
Definice 0.133 (Komponenty souvislosti). Komponenty souvislosti jsou podgrafy indukované třídami ekvivalence.
Definice 0.134 (Vzdálenost v grafu). Vzdálenost
v souvislém grafu
je definována jako
je minimum z délek mezi
a
.
Pro metriku musí platit
:
... je minimum z délek cest, cesty jsou také nezáporné
... nikde jinde (krom ) vzdálenost nulová není
... vzdálenost mezi a je shora omezená mezi vzdáleností a
Definice 0.135 (Strom). Strom je souvislý graf bez kružnic. (acyklicky graf)
Definice 0.136 (Les). Les je acyklicky graf. Jeho komponenty souvislosti jsou stromy.
Definice 0.137 (List). List je vrchol stupně .
Věta 0.57. Každý strom s alespoň dvěma vrcholy má alespoň jeden list.
Věta 0.58. Pro graf s listem platí, že je strom je strom.
Věta 0.59 (Eulerova formule). Pro souvislý máme počet hran stromu .
Věta 0.60 (Ekvivalentní charakteristiky). Pro graf jsou následující tvrzení ekvivalentní:
je souvislý a acyklický (=strom)
cesta v mezi a (=jednoznačná souvislost)
je souvislý a není souvislý (=minimální souvislost)
je acyklický a má cyklus (=maximálně acyklický)
je souvislý a (=Eulerova formule)
Věta 0.61. V grafu platí:
Věta 0.62. Každá kružnice má právě koster.
Definice 0.138 (Rovinný graf). Rovinný graf je takový graf, pro nějž existuje nějaké nakreslení v rovině.
Definice 0.139 (Rovinné nakreslení). Rovinné nakreslení je přiřazení různých bodů v rovině různým vrcholům , spojené s přiřazením oblouků každé hraně z – aby bylo nakreslení rovinné, tak žádné dva oblouky nesmí sdílet jeden bod v rovině, jedině ten koncový.
Definice 0.140 (Stěna). Stěna je oblast ohraničená hranami.
Věta 0.63 (Kuratowski). Graf je rovinný neobsahuje podgraf izomorfní s dělením nebo .
Věta 0.64 (Eulerova formule). Nechť je souvislý graf nakreslený do roviny a je počet stěn nakreslení. Potom platí . (pro počet komponent: .)
Proof. Zvolíme pevně a pak indukcí podle .
( je strom), : .
:
mějme graf
s
hranami. Nechť
je hrana na kružnici v
.
Potom
,
,
,
.
Nyní použijeme indukční předpoklad:
◻
Věta 0.65 (Maximální počet hran rovinného grafu). V každém rovinném grafu s alespoň vrcholy platí:
Proof. Doplním do hrany, až získám maximální rovinný graf . Takže , . Každá stěna přispěje třemi hranami, kadždá hrana dvěma stěnám, tedy . Nyní jen dosadíme: ◻
Důsledek 0.3. Pokud je graf bipartitní, pak .
Věta 0.66. V rovinném grafu existuje vrchol stupně nejvýše .
Věta 0.67 (O 4 barvách). Každý rovinný graf lze obarvit nejvýše 4 barvami.
Definice 0.141 (Vrcholové -obarvení grafu). Obarvení grafu barvami je funkce , že pokud , pak .
Definice 0.142 (Vrcholová barevnost grafu). Barevnost je nejmenší takové, že existuje -obarvení .
Věta 0.68. je bipartitní nemá lichou kružnici.
Definice 0.143 (Klikovost). Klikovost je rovna velikosti největší kliky (úplného podgrafu ) v .
Věta 0.69 (Barevnost a klikovost). .
Věta 0.70. Pro maximální stupeň v grafu platí .
Definice 0.144 (Hranový řez). je hranový řez v pokud je nesouvislý.
Definice 0.145 (Hranová souvislost). Graf je hranově souvislý, pokud neobsahuje žádný hranový řez velikosti menší než .
Definice 0.146 (Vrcholový řez). je vrcholový řez v pokud podgraf indukovaný je nesouvislý.
Definice 0.147 (Vrcholová -souvislost). Graf je vrcholově -souvislý, pokud má alespoň vrcholů a neobsahuje žádný vrcholový řez velikosti .
Věta 0.71 (Menger – hranová verze). Pro dva různé vrcholy grafu platí, že obsahuje hranově disjunktních cest z do neobsahuje hranový řez velikosti menší než .
Věta 0.72 (Menger – vrcholová verze). Pro dva různé nesousední vrcholy grafu platí, že obsahuje navzájem vrcholově disjunktních cest z do neobsahuje vrcholový -řez velikosti .
Věta 0.73 (Menger – hranová verze). Graf je hranově -souvislý mezi každými dvěma různými vrcholy existuje hranově disjunktních cest.
Věta 0.74 (Menger – vrcholová verze). Graf je vrcholově -souvislý mezi každými dvěma různými vrcholy existuje navzájem vnitřně vrcholově disjunktních cest.
Definice 0.148 (Otevřený eulerovský tah). Otevřený eulerovský tah z do je takový tah, který obsahuje všechny vrcholy a hrany grafu právě jednou.
Definice 0.149 (Uzavřený eulerovský tah). Uzavřený eulerovský tah je takový eulerovský tah, kde .
Definice 0.150 (Orientovaný graf). Orientovaný graf je uspořádaná dvojice , kde
Definice 0.151 (Podkladový graf). Podkladový graf grafu je graf , kde Neboli množina všech neuspořádaných dvojic vrcholů, kde v jednom nebo druhém pořadí je hrana.
Definice 0.152 (Silná souvislost). Pokud pro existuje orientovaná cesta z do .
Definice 0.153 (Slabá souvislost). Pokud podkladový graf je souvislý.
Věta 0.75. Pro orientovaný graf je ekvivalentní:
je vyvážený (, sudý stupeň) a slabě souvislý,
má uzavřený eulerovský tah,
je vyvážený a silně souvislý.
Definice 0.154 (Toková síť). Je pětice :
množina vrcholů
množina orientovaných hran
zdroj
stok/ spotřebič
je kapacita hrany
Definice 0.155 (Tok). V síti je tok funkce splňující:
,
,respektive .
Definice 0.156 (Velikost toku). Velikost toku v síti je .
Definice 0.157 (Maximální tok). Maximální tok je takový tok, který má největší velikost.
Definice 0.158 (Řez). v síti je množiana hran , t.ž.: každá orientovaná cesta ze do má neprázdný průnik s .
Kapacita řezu
Minimální řez je řez, který má ze všech řezů nejmenší kapacitu.
Definice 0.159 (Nenasycená cesta). Nechť je tok v síti . Nenasycená cesta pro je neoreintovaná cesta , kde
je buď dopředná hrana, tedy , nebo
je zpětná hrana, tedy .
Zároveň platí pro každou dopřednou hranu a pro každou zpětnou hranu.
Definice 0.160 (Zlepšující cesta). Zlepšující cesta pro je nenasycená cesta ze do .
nulový tok
tok
.
Věta 0.76. Nechť je tok v síti , potom následující tvrzení jsou ekvivalentní:
je maximální
nemá zlepšující cestu
Existuje řez , t.ž.: .
Věta 0.77 (Minimax). Velikost maximálního toku je rovna kapacitě minimáního řezu.
Definice 0.161 (Pravděpodobnost). Nechť je množina elementárních jevů a je podmnožina elementárních jevů. Potom pravděpodobnost je funkce
Definice 0.162 (Diskrétní pravděpodobnostní prostor). Diskrétní pravděpodobnostní prostor je trojice , kde je konečná nebo spočetná, a .
Definice 0.163 (Konečný pravděpodobnostní prostor). Konečný pravděpodobnostní prostor je diskrétní, kde je konečná.
Definice 0.164 (Klasický pravděpodobnostní prostor). Klasický pravděpodobnostní prostor je konečný, kde .
Definice 0.165 (Elementární jev). Všechny výsledky nějakého pravděpodobnostního experimentu. Značíme jako .
Definice 0.166 (Složený jev). Složený jev je takový jev, který není elementární. Složený jev nastane nastane některý z elementárních jevů v něm obsažený.
Definice 0.167 (Pravděpodobnost jevu). Pravděpodobnost jevu udává, jakou máme šanci, že daný jev nastane.
Věta 0.78 (Základní pravidla pro počítání). V pravděpodobnostním prostoru platí pro :
,
,
.
Definice 0.168 (Nezávislost náhodných jevů). Jevy a jsou nezávislé .
Definice 0.169 (Podmíněná pravděpodobnost). Podmíněná pravděpodobnost je pravděpodobnost, že nastal jev za podmínek, že nastal jev .
Věta 0.79 (Bayesova věta). Nechť je jev, kde a je rozklad na jevy t.ž. . Potom:
Věta 0.80 (O úplné pravděpodobnosti). Nechť je rozklad na jevy t.ž. , pak
Definice 0.170 (Náhodná veličina). Náhodná veličina je zobrazení , které splňuje:
Definice 0.171 (Diskrétní náhodná veličina). Funkci nazveme diskrétní náhodná veličina, pokud je obor hodnot spočetná množina a pokud platí: .
Definice 0.172 (Spojitá náhodná veličina). Náhodná veličina se nazývá spojitá, pokud existuje nezáporná reálná funkce tak, že
Definice 0.173 (Hustota pravděpodobnosti). Pro spojitou náhodnou veličinu je hustota pravděpodobnosti nezáporná funkce , pro kterou platí, že celková plocha pod její křivkou je rovna 1:
Definice 0.174 (Indikátorová náhodná veličina). Pro libovolný jev definujeme indikátorovou n.v. : pokud jinak.
Definice 0.175 (Bernoulliho rozdělení). Pro je
,
( může být například počet orlů při jednom hodu nespravedlivou mincí.)
Definice 0.176 (Geometrické rozdělení). Pro je
,
Pro dané máme pro .
( může být například kolikátým hodem mincí padl první orel.)
Definice 0.177 (Binomické rozdělení). Pro je
,
Pro dané máme , pro .
( může být například počet orlů při hodech nespravedlivou mincí.)
Definice 0.178 (Hypergeometrické rozdělení). Pro je
,
.
Pro dané máme
( může být například počet vytažených červených míčku při tazích, v osudí je červených z celkových míčků.)
Definice 0.179 (Poissonovo rozdělení). Pro je
,
.
Pro dané a reálné máme . Platí, že je limitou .
( může být například počet emailů, které dostaneme za jednu hodinu.)
Definice 0.180 (Normální rozdělení). Pro je
,
.
Platí, že , kde .
Definice 0.181 (Exponenciální rozdělení). Pro je
,
.
( může být například čas před příchodem dalšího telefonního hovoru do call-centra/ dotazu na web-server/čas do dalšího blesku v bouřce apod.)
Definice 0.182 (Distribuční funkce). Distribuční funkce n.v. je funkce
je neklesajíci a zprava spojitá funkce
Definice 0.183 (Střední hodnota). Střední hodnota náhodné veličiny je .
Věta 0.81 (Linearita střední hodnoty). Nechť jsou nezávislé náhodné veličiny a , potom
Věta 0.82. Nechť jsou nezávislé diskrétní náhodné veličiny, potom .
Definice 0.184 (Markovova nerovnost). Nechť je nezáporná náhodná veličina a , potom platí:
Definice 0.185 (Rozptyl). Rozptyl n.v. , značeno , nazveme číslo .
Definice 0.186 (Kovariance). Kovariance měří míru lineární závislosti dvou náhodných veličin a . Značí se a platí: Pokud jsou veličiny a nezávislé, jejich kovariance je rovna 0 (neplatí to ale nutně naopak).
Věta 0.83.
Věta 0.84 (Rozptyl součtu nezávislých veličin). Pro nezávislé diskrétní nebo spojité n.v. platí
Věta 0.85 (Rozptyl součtu závislých veličin). Pro libovolné dvě náhodné veličiny a (závislé i nezávislé) platí obecný vzorec pro rozptyl součtu:
Definice 0.187 (Spojitý rozptyl). Rozptyl spojité n.v. je .
Věta 0.86 (Zákon velkých čísel). Nechť jsou stejné rozdělené n.n.v. se střední hodnotou a rozptylem . Označme . Pak pro každé platí Říkáme, že posloupnost konverguje k v pravděpodobnosti, píšeme .
Věta 0.87 (Centrální limitní věta). Nechť jsou stejně rozdělené n.n.v se střední hodnotou a rozptylem . Označme Pak . Neboli, pokud je distribuční funkce , tak Říkáme, že posloupnost konverguje k v distribuci.
Chceme určit hodnotu nějakého parametru – často střední hodnoty neznámého rozdělení.
Definice 0.188 (Bodový odhad). Pro náhodný výběr a libovolnou funkci nazveme bodový odhad :
nestranný, pokud ,
asymptoticky nestranný, pokud ,
konzistentní, pokud ,
vychýlení
střední kvadratickou chybu
Věta 0.88 (Parametry výběrového momentu a rozptylu). Máme:
je konzistentní nestranný odhad
je konzistentní asymptoticky nestranný odhad
je konzistentní nestranný odhad
Volíme takové , které řeší soustavu rovnic Nechť -tý moment náhodné veličiny je a označme:
pro jako -tý moment (průměr z celé populace)
jako -tý výběrový moment (průměr z náhod. výběru z )
Věta 0.89. je nestranný konzistentní odhad pro .
Nechť , kde “-tý člověk je levák”. Potom a . Celkem
Místo jednoho čísla s nejistým významem vypočítáme z dat interval .
Definice 0.189 (Interval spolehlivosti). Nechť , hladina významnost, kritická hodnota (chceme pokrýt plochy pod křivkou normálního rozdělení), směrodatná odchylka, rozsah výběru a standardní chyba, pak interval spolehlivosti je Interval spolehlivosti říká, že s jistotou se skutečný průměr celé populace nachází v tomto rozmezí.
Tato metoda využívá centrální limitní větu (CLV) a je vhodná pro velké výběry ().
Bodový odhad: Pro střední hodnotu použijeme
Standardní chyba (SE):
Pokud je známý rozptyl , tak
Pokud rozptyl neznáme, odhadneme ho pomocí výběrového rozptylu:
Kvantily rozdělení:
Pro známý rozptyl použijeme normální rozdělení :
Pro neznámý rozptyl a malé výběry použijeme Studentovo -rozdělení s stupni volnosti:
Interval spolehlivosti:
Používá se například pro odhady průměrné výšky, hmotnosti, doby života.
Jedná se o metodu pro rozhodování o platnosti určitých hypotéz na základě pozorovaných dat.
Postupujeme následovně:
Formulujeme nulovou hypotézu () - konzervativní tvrzení, které testujeme (např. "mince je spravedlivá", "lék nemá účinek").
Stanovíme alternativní hypotézu () - tvrzení, které platí, pokud neplatí (např. "mince je falešná", "lék má účinek").
Zvolíme testovou statistiku , která měří odchylku dat od .
Určíme kritický obor - množinu hodnot statistiky, pro které zamítneme .
Vypočteme pozorovanou hodnotu statistiky .
Rozhodneme: pokud , zamítneme ve prospěch ; jinak nezamítáme.
Při rozhodování můžeme udělat dva typy chyb:
Chyba 1. druhu: Zamítneme , i když platí.
Chyba 2. druhu: Nezamítneme , i když neplatí.
Síla testu: Pravděpodobnost správného zamítnutí , když neplatí.
Hladina významnosti je pravděpodobnost chyby 1. druhu, kterou jsme ochotni akceptovat. Typické volby jsou nebo . Kritický obor pak volíme, aby:
Definice 0.190 (Jazyk VL). Jazyk výrokové logiky je určený neprázdnou množinou výrokových proměnných . Patří do něj také symboly pro logické spojky a závorky , .
Definice 0.191 (Výroková formule). Výrok v jazyce je prvek množiny definované následovně: je nejmenší množina splňující
pro každý prvovýrok platí ,
pro každý výrok je také prvek
pro každé jsou , a také prvky .
Definice 0.192 (Signatura). Signatura je dvojice , kde jsou disjunktní množiny symbolů (relační a funkční, ty zahrnují konstantní) spolu s danými aritami (tj. danými funkcí ) a neobsahující symbol ‘’ (ten je rezervovaný pro rovnost).
Definice 0.193 (Jazyk PL). Jazyk predikátové logiky je dán signaturou a uvedením, zda jde o jazyk s rovností, či bez. Patří do něj spočetně mnoho proměnných, relační, funkční a konstantní symboly ze signatury (případně “”), univerzální a existenční kvantifikátory , symboly pro logické spojky a závorky .
Definice 0.194 (Termy). Termy jazyka jsou konečné nápisy definované induktivně:
každá proměnná a každý konstantní symbol z je term,
je-li funkční symbol z arity a jsou-li termy, potom nápis je také term.
Množinu všech termů jazyka označíme .
Definice 0.195 (Formule). Formule jazyka jsou konečné nápisy definované induktivně. Platí stejné tři body jako u výroku, plus: Je-li formule a proměnná, potom a jsou také formule.
Definice 0.196 (Otevřená formule). Formule je otevřená, pokud neobsahuje žádný kvantifikátor.
Definice 0.197 (Sentence). Formule je uzavřená (sentence), pokud nemá žádnou volnou proměnnou.
Definice 0.198 (Literál). Literál je buď prvovýrok nebo negace prvovýroku .
Definice 0.199 (Klauzule). Klauzule je disjunkce literálů . Jednotková klauzule je samotný literál () a prázdnou klauzulí () myslíme .
Definice 0.200 (CNF). Výrok je v konjunktivní normální formě (v CNF) pokud je konjunkcí klauzulí. Prázdný výrok v CNF je .
Definice 0.201 (Elementární konjunkce). Elementární konjunkce je konjunkce literálů . Jednotková elementární konjunkce je samotný literál (). Prázdná () je .
Definice 0.202 (DNF). Výrok je v disjunktivní normální formě (v DNF) pokud je disjunkcí elementárních konjunkcí. Prázdný výrok v DNF je .
Věta 0.90 (Převod CNF DNF). Mějme konečný jazyk a libovolnou množinu modelů . Potom existuje výrok v DNF a výrok v CNF takový, že . Konkrétně:
2
Implikace a ekvivalence:
Negace:
Konjunkce (převod do DNF):
Disjunkce (převod do CNF):
Definice 0.203 (SAT). Výrok je v -CNF, pokud je v CNF a každá klauzule má nejvýše literálů. Problém -SAT se ptá, zda je daný -CNF výrok splnitelný. Pro je -SAT nadále NP-úplný, každou CNF formuli lze zakódovat do 3-CNF výroku.
Definice 0.204 (PNF). Formule je v prenexní normální formě (PNF), je-li tvaru kde je kvantifikátor ( nebo ) a formule je otevřená. Formuli potom říkáme otevřené jádro a je kvantifikátorový prefix.
Věta 0.91 (Existence PNF). Ke každé formuli existuje ekvivalentní formule v prenexní normální formě.
Věta 0.92 (Převod do PNF). Označme jako kvantifikátor opačný ke . Nechť a jsou formule, a proměnná nechť není volná ve formuli . Potom platí:
Definice 0.205 (Rezoluční pravidlo). Mějme klauzule a a literál takový, že a . Potom rezolventa klauzulí a přes literál je klauzule
Definice 0.206 (Rezoluční důkaz). Rezoluční důkaz (odvození) klauzule z CNF formule je konečná posloupnost klauzulí taková, že pro každé buď nebo je rezolventou nějakých kde a .
Pokud rezoluční důkaz existuje, říkáme, že je rezolucí dokazatelná z , a píšeme . (Rezoluční) zamítnutí CNF formule je rezoluční důkaz z , v tom případě je (rezolucí) zamítnutelná.
Definice 0.207 (Rezoluční strom). Rezoluční strom klauzule z CNF formule je konečný binární strom s vrcholy označenými klauzulemi, kde
v kořeni je ,
v listech jsou klauzule z ,
v každém vnitřním vrcholu je rezolventa klauzulí ze synů tohoto vrcholu.
Definice 0.208 (Rezoluční uzávěr). Rezoluční uzávěr formule je definován induktivně jako nejmenší množina klauzulí splňující:
pro všechna ,
jsou-li a je-li rezolventa , potom také .
Definice 0.209 (Teorie). Teorie v jazyce je libovolná množina výroků v . Jednotlivým výrokům říkáme také axiomy.
Definice 0.210 (Model teorie PL). Struktura v jazyce je modelem teorie , , pokud každá sentence je v pravdivá.
Definice 0.211 (Pravdivostní funkce).
Pravdivostní funkce výroku
v konečném jazyce
je funkce
definovaná induktivně:
je-li -tý prvovýrok z , potom ,
je-li , potom
je-li kde , potom
Definice 0.212 (Model jazyka VL). Model jazyka je libovolné pravdivostní ohodnocení . Množinu (všech) modelů jazyka označíme :
Definice 0.213 (Model jazyka PL). Model jazyka , nebo také -struktura, je libovolná struktura v signatuře jazyka . Třídu všech modelů jazyka označíme .
Definice 0.214 (Struktura). Struktura v signatuře je trojice , kde
je neprázdná množina, říkáme jí doména (také univerzum),
kde je interpretace relačního symbolu ,
kde je interpretace funkčního symbolu (speciálně pro konstantní symbol máme ).
Definice 0.215 (Platnost výroku v modelu, model výroku). Mějme výrok v jazyce a model . Pokud platí , potom říkáme, že výrok platí v modelu , je modelem , a píšeme . Množinu všech modelů výroku označujeme .
Definice 0.216 (Platnost teorie, model teorie). Je-li teorie v jazyce , potom platí v modelu , pokud každý axiom platí ve . V tom případě říkáme také, že je modelem , a píšeme . Množinu všech modelů teorie v jazyce označíme .
Definice 0.217 (Sémantické pojmy). Říkáme, že výrok (v jazyce ) je
pravdivý, tautologie, platí (v logice/logicky), a píšeme , pokud platí v každém modelu (jazyka ), ,
lživý, sporný, pokud nemá žádný model, .
nezávislý, pokud platí v nějakém modelu, a neplatí v nějakém jiném modelu, tj. není pravdivý ani lživý, ,
splnitelný, pokud má nějaký model, tj. není lživý, .
Dále říkáme, že výroky (ve stejném jazyce ) jsou (logicky) ekvivalentní, píšeme pokud mají stejné modely, tj.
Definice 0.218 (Sémantické pojmy vzhledem k teorii). Mějme teorii v jazyce . Říkáme, že výrok v jazyce je
pravdivý v , důsledek , platí v , a píšeme , pokud platí v každém modelu teorie , neboli ,
lživý v , sporný v , pokud neplatí v žádném modelu , neboli .
nezávislý v , pokud platí v nějakém modelu , a neplatí v nějakém jiném modelu , tj. není pravdivý v ani lživý v , ,
splnitelný v , konzistentní s , pokud platí v nějakém modelu , tj. není lživý v , .
A říkáme, že výroky (ve stejném jazyce ) jsou ekvivalentní v , -ekvivalentní, píšeme pokud platí v týchž modelech , tj.
Definice 0.219. Řekneme, že teorie v jazyce je
sporná, jestliže v ní platí (spor), ekvivalentně, jestliže nemá žádný model,
bezesporná (splnitelná), pokud není sporná, tj. má nějaký model,
kompletní, jestliže není sporná a každý výrok je v ní pravdivý nebo lživý, ekvivalentně, pokud má právě jeden model.
Definice 0.220 (Extenze teorie). Mějme teorii v jazyce .
Extenze teorie je libovolná teorie v jazyce splňující ,
je to jednoduchá extenze, pokud ,
je to konzervativní extenze, pokud .
Redukujeme otázku splnitelnosti dané teorie na otázku splnitelnosti otevřené teorie . Celá konstrukce sestává z následujících kroků:
Převod do prenexní normální formy (vytýkání kvantifikátorů).
Nahrazení formulí jejich generálními uzávěry (abychom získali sentence – přidáme “”).
Odstranění existenčních kvantifikátorů (nahrazení sentencí Skolemovými variantami – odstraníme “” a substituujeme “”).
Odstranění zbývajících univerzálních kvantifikátorů (výsledkem jsou otevřené formule).
Pokud důkaz existuje, lze ho nalézt ‘algoritmicky’. Navíc musíme být schopni algoritmicky ověřit, že je daný objekt opravdu korektní důkaz. Existuje-li důkaz, říkáme, že je dokazatelný z , a píšeme . Po dokazovacím systému požadujeme dvě vlastnosti:
korektnost: je-li výrok dokazatelný z teorie, je v ní pravdivý ()
úplnost: je-li výrok pravdivý v teorii, je z ní dokazatelný ()
Definice 0.221 (Tablo). Konečné tablo z teorie je uspořádaný, položkami označkovaný strom zkonstruovaný aplikací konečně mnoha následujících pravidel:
jednoprvkový strom označkovaný libovolnou položkou je tablo z teorie ,
pro libovolnou položkou na libovolné větvi , můžeme na konec větve připojit atomické tablo pro položku ,
na konec libovolné větve můžeme připojit položku pro libovolný axiom teorie .
Tablo z teorie je buď konečné, nebo i nekonečné: v tom případě vzniklo ve spočetně mnoha krocích. Můžeme ho formálně vyjádřit jako sjednocení , kde jsou konečná tabla z , je jednoprvkové tablo, a vzniklo z v jednom kroku.
Tablo pro položku je tablo, které má položku v kořeni.
Definice 0.222 (Tablo důkaz). Tablo důkaz výroku z teorie je sporné tablo z teorie s položkou v kořeni. Pokud existuje, je (tablo) dokazatelný z , píšeme . (Definujme také tablo zamítnutí jako sporné tablo s v kořeni. Pokud existuje, je (tablo) zamítnutelný z , tj. platí .)
Tablo je sporné, pokud je každá jeho větev sporná.
Větev je sporná, pokud obsahuje položky a pro nějaký výrok , jinak je bezesporná.
Tablo je dokončené, pokud je každá jeho větev dokončená.
Větev je dokončená, pokud
je sporná, nebo
je každá její položka na této větvi redukovaná a zároveň obsahuje položku pro každý axiom .
Položka je redukovaná na větvi procházející touto položkou, pokud
je tvaru resp. pro nějakou výrokovou proměnnou , nebo
vyskytuje se na jako kořen atomického tabla (tj., typicky, při konstrukci tabla již došlo k jejímu rozvoji na ).
Věta 0.93 (Konečnost sporu). Je-li sporné tablo, potom existuje takové, že je sporné konečné tablo.
Důsledek 0.4 (Konečnost důkazu). Pokud , potom existuje i konečný tablo důkaz z .
| True | ] |
]] |
] |
] |
] [ []]] |
| False | ] |
] |
]] |
]] |
] [ []]] |
Věta 0.94 (O kompaktnosti). Teorie má model, právě když každá její konečná část má model.
Důsledek 0.5. Spočetně nekonečný graf je bipartitní, právě když je každý jeho konečný podgraf bipartitní.
Věta 0.95 (O úplnosti VL). Je-li výrok pravdivý v teorii , potom je tablo dokazatelný z , tj.
Věta 0.96 (O úplnosti PL). Je-li sentence pravdivá v teorii , potom je tablo dokazatelná z , tj.
Definice 0.223 (Kompletní teorie ve VL). Teorie je kompletní, je-li bezesporná a každý výrok je buď pravdivý, nebo lživý. Ekvivalentně, právě když má jeden model.
Definice 0.224 (Kompletní teorie v PL). Teorie je kompletní, je-li bezesporná a každá sentence je v ní buď pravdivá, nebo lživá. Ekvivalentně, právě když má právě jeden model až na elementární ekvivalenci.
Definice 0.225 (Elementární ekvivalence). Struktury (v témž jazyce) jsou elementárně ekvivalentní, pokud v nich platí tytéž sentence. Značíme .
Definice 0.226 (Teorie struktury). Mějme -strukturu . Teorie struktury , značíme je množina všech -sentencí platných v :
Definice 0.227 (Rekurzivní axiomatizace). Teorie je rekurzivně axiomatizovaná, pokud existuje algoritmus, který pro každou vstupní formuli doběhne a odpoví, zda .
Definice 0.228 (Rozhodnutelnost). O teorii říkáme, že je
rozhodnutelná, pokud existuje algoritmus, který pro každou vstupní formuli doběhne a odpoví, zda ,
částečně rozhodnutelná, pokud existuje algoritmus, který pro každou vstupní formuli :
pokud , doběhne a odpoví “ano”,
pokud , buď nedoběhne, nebo doběhne a odpoví “ne”.
Věta 0.97. Nechť je rekurzivně axiomatizovaná. Potom:
je částečně rozhodnutelná,
je-li navíc kompletní, potom je rozhodnutelná.
Definice 0.229 (Rekurzivní axiomatizovatelnost). Třída -struktur je rekurzivně axiomatizovatelná, pokud existuje rekurzivně axiomatizovaná -teorie taková, že . Teorie je rekurzivně axiomatizovatelná, pokud je rekurzivně axiomatizovatelná třída jejích modelů, neboli pokud je ekvivalentní nějaké rekurzivně axiomatizované teorii.
Pro následující struktury je rekurzivně axiomatizovatelná, a tedy i rozhodnutelná:
, jde o tzv.teorii diskrétních lineárních uspořádání,
, teorie následníka s nulou,
, teorie reálně uzavřených těles,
, teorie algebraicky uzavřených těles charakteristiky 0.
Z následujících témat budou vybrána .
Definice 0.230 (Jazyk). Jazyk nad abecedou je libovolná podmnožina .
Definice 0.231 (Regulární gramatika (Typ 3)). Gramatika je regulární, pokud obsahuje pouze pravidla:
Definice 0.232 (DFA). Deterministický konečný automat (DFA) je pětice , kde:
konečné množiny stavů ,
konečné neprázdné množiny vstupních symbolů (abecedy) ,
přechodové funkce ,
počátečního stavu ,
a množiny koncových (přijímajících) stavů .
Definice 0.233 (-NFA). Nedeterministický konečný automat s přechody (-NFA) je pětice , kde přechodová funkce je zobrazení vracející podmnožinu , a zbytek je jako v DFA.
Definice 0.234 (Rozšířená přechodová funkce). Mějme přechodovou funkci . Rozšířenou přechodovou funkci definujeme induktivně:
,
, pro .
Definice 0.235 (DFA přijímá slovo ). DFA přijímá slovo , pokud po přečtení celého slova končí v přijímajíím stavu. Tedy pro rozšířenou přechodovou funkci je slovo přijato, pokud .
Definice 0.236 (Regulární výrazy (RegE), hodnota RegE )). Regulární výrazy nad konečnou neprázdnou abecedou a jejich hodnota jsou definovány induktivně:
| výraz | pro | hodnota |
|---|---|---|
| prázdný řetězec | ||
| prázdný výraz | ||
| výraz | hodnota | |
|---|---|---|
Každý regulární výraz dostaneme indukcí výše, tj. třída je nejmenší třída uzavřená na uvedené operace.
Definice 0.237 (Formální (generativní) gramatika). Formální gramatika je složena z:
konečné množiny neterminálů ,
neprázdné konečné množiny terminálů ,
počátečního symbolu ,
konečné množiny pravidel reprezentující rekurzivní definici jazyka. Každé pravidlo má tvar: tj. levá strana obsahuje alespoň jeden neterminální symbol.
Definice 0.238 (Bezkontextová gramatika (CFG)). CFG je gramatika, obsahující pouze pravidla tvaru:
Definice 0.239 (Derivace ). Mějme gramatiku .
Říkáme, že se přímo přepíše na (píšeme nebo ), jestliže:
Říkáme, že se přepíše na (píšeme ), jestliže:
Posloupnost nazýváme derivací (odvozením).
Definice 0.240 (Jazyk generovaný gramatikou ). Jazyk generovaný gramatikou je množina terminálních řetězců, pro které existuje derivace ze startovního symbolu: Jazyk neterminálu definujeme:
Definice 0.241 (Zásobníkový automat (PDA)). PDA je , kde:
je konečná množina stavů,
je neprázdná konečná množina vstupních symbolů,
je neprázdná konečná zásobníková abeceda,
je přechodová funkce: platí , kde ‘’ je aktuální stav, ‘’ je aktuálně čtený symbol, ‘’ je symbol na vrcholu zásobníku, ‘’ je nový stav, do kterého automat přejde a ‘’ je řetězec zásobníkových symbolů, který nahradí na vrcholu zásobníku,
je počáteční stav,
je počáteční zásobníkový symbol (na začátku je jediný symbol na zásobníku),
je množina přijímajících (koncových) stavů; může být nedefinovaná.
Definice 0.242 (Turingův stroj (TM)). Turingův stroj (TM) je sedmice , kde:
je konečná množina stavů,
je konečná neprázdná množina vstupních symbolů,
je konečná množina všech symbolů pro pásku (, ),
je (částečná) přechodová funkce: kde znamená:
je aktuální stav,
je aktuální symbol na pásku,
je nový stav,
je symbol pro zapsání do aktuální buňky,
je směr pohybu hlavy (doleva, doprava).
je počáteční stav,
je symbol pro prázdné buňky (blank),
je množina koncových (přijímajících) stavů.
Definice 0.243 (Problémem). Problémem myslíme množinu otázek kódovatelnou řetězci nad abecedou s odpověďmi . Pokud problém definujeme jakožto množinu, jde o otázku, zda vstup kóduje prvek dané množiny (např. polynom s celočíselným kořenem).
Definice 0.244 (Rozhodnutelný problém). Problém je (algoritmicky) rozhodnutelný, pokud existuje Turingův stroj takový, že pro každý vstup zastaví a navíc přijme právě když Problém, který není algoritmicky rozhodnutelný je nerozhodnutelný.
Definice 0.245 (Problém zastavení). Instancí
problému zastavení je dvojice řetězců
.
Problém zastavení je najít algoritmus
Halt,
který vydá
právě když stroj
zastaví na vstupu
,
jinak vydá
.
Věta 0.98 (Problém zastavení). Problém zastavení není rozhodnutelný.
Definice 0.246 (Chomského hierarchie). Gramatiky rozdělujeme do čtyř typů:
Gramatiky typu 0 (rekurzivně spočetné jazyky
)
Pravidla v obecné formě:
a
obsahuje alespoň jeden neterminální symbol.
Gramatiky typu 1 (kontextové gramatiky, jazyky
)
Pouze pravidla ve tvaru:
Výjimkou je pravidlo
,
pak se
nesmí vyskytovat na pravé straně žádného pravidla.
Gramatiky typu 2 (bezkontextové gramatiky, jazyky
)
Pouze pravidla ve tvaru:
Gramatiky typu 3 (regulární gramatiky, jazyky
)
Pouze pravidla ve tvaru:
kde
a
.
Počáteční stav je zachován (včetně jeho -uzávěru).
Přijímající stavy jsou všechny množiny obsahující nějaký přijímající stav.
Každý nový stav odpovídá množině stavů NFA. (Pro každý symbol z spočítáme množinu stavů, do kterých se NFA může dostat, a ta tvoří nový stav v DFA.)
Mějme NFA se stavy , počátečním stavem , koncovým stavem a přechody: , , .
Každý neterminál odpovídá stavu automatu + vytvoříme koncový stav .
Počáteční stav gramatiky je počátční stav automatu.
Tvar zapíšeme v automatu jako .
Tvar zapíšeme v automatu jako .
Tvar zapíšeme v automatu jako koncový stav.
Každému stavu automatu přiřadíme neterminál .
Počátečnímu stavu přiřadíme počáteční neterminál.
Přechod zapíšeme v gramatice jako pravidlo .
Pokud je stav koncový, přidáme pravidlo .
Převedeme automat na regulární gramatiku (soustavu rovnic pro jednotlivé stavy).
Součet koncových stavů DFA bude tvořit výslednou rovnici.
Následně dosazujeme do stavů a převádíme je na RegEx.
Převod na RegEx: výraz ve tvaru (příp. ) přepíšeme pomocí Ardenova pravidla na (resp. ).
Součet koncových stavů je výsledný jazyk.
Sestavíme rovnice pro jednotlivé stavy (podle vstupujících/vystupujících cest):
Dosadíme a do rovnice pro :
Dosadíme zpět do . Výsledný regulární výraz:
Pro každý RegEx symbol vytvoříme NFA s jedním přechodem. (symbol bude .)
Pokud je RegEx ve tvaru , pak automaty řadíme za sebe (skládáme).
Pokud je RegEx ve tvaru , pak přidáme počáteční stav, který se větví do automatů pro a , a ty jsou následně sloučeny do jednoho koncového stavu přes .
Pokud je RegEx ve tvaru , pak vytváříme zpětnou smyčku / cyklus.
Zřetězení ():
Sjednocení (): Větvení z počátku přes do větví pro a a následné sloučení do koncového stavu:
Iterace (): Smyčka se zpětným -přechodem a možností přeskočení přes .
Odstraníme -pravidla, jednotková pravidla () a zbytečné symboly (negenerující a nedosažitelné).
Pro každý terminál vytvoříme nový neterminál a přidáme pravidlo .
Převedeme pravidla na délku nejvýše 2 neterminálů (tvar nebo ).
Mějme výchozí gramatiku:
Odstranění -pravidel (): Kdekoliv je na pravé straně , přidáme i variantu bez něj:
Odstranění jednotkových pravidel:
nahradíme za , tedy
nahradíme za pravé strany a :
Odstranění nedosažitelných symbolů: Neterminál není dosažitelný z počátečního stavu , proto pravidlo odstraníme. Zbývá:
Převod do finálního CNF tvaru: Pravidlo obsahuje terminál i neterminál. Zavedeme nový neterminál a pravidlo přepíšeme na .
Mějme CFG gramatiku , a konstruujeme PDA .
Počáteční symbol gramatiky vložíme na zásobník.
Pro neterminály .
Pro každý terminál . (pop)
Přijímání probíhá prázdným zásobníkem.
Mějme gramatiku . Sestrojíme PDA :
Expanze neterminálu:
Čtení a odstranění terminálů:
Definice 0.247 (Časová složitost). Nechť je doba běhu pro vstup . Potom časová složitost výpočtu:
Definice 0.248 (Prostorová složitost). Nechť “max adresa min adresa ” je prostor běhu pro vstup . Potom prostorová složitost výpočtu je
Mějme funkce .
Definice 0.249 (Horní odhad).
Definice 0.250 (Dolní odhad).
Definice 0.251 (Těsný odhad).
Definice 0.252 (Třída ). Problém existuje algoritus a polynom , že pro každý vstup , algoritmus doběhne v čase nejvýše a vrátí výsledek .
Definice 0.253 (Třída
).
Problém
problém a polynom
,
že
právě tehdy, když pro nějaký řetězec
délky nejvýše
platí
.
(“
řeší
,
ale krom vstupu
má nápovědu
.
Pokud
,
pak musí existovat nápověda
,
kterou
schválí.”)
Definice 0.254 (-těžkost). Problém je NP-těžký, pokud na něj lze převést libovolný problém v NP.
Definice 0.255 (-úplnost). Problém je NP-úplný, pokud je NP-těžký a je v NP.
Definice 0.256 (Převod). Platí, že , že a běží v polytime.
SAT 3-SAT: přidáme literály: .
3-SAT Nezávislá množina: klauzule tvoří trojúhelníky. Spojujeme s . Viz obrázek.
3-SAT 3,3-SAT: proměnné rozdělíme a zařídíme stejné ohodnocení kolečkem implikací .
3,3-SAT 3D párování (Na vstupu . Na výstupu: Existuje podmnožina, v níž se každý prvek účastní právě jednou?
Dokážeme, že NP (sestrojíme poly verifikátor ). NP-těžkost sestrojíme poly převodem z již známého NPÚ problému ().
Rekurzivně dělíme na podproblémy – problém velikosti na dva apod. Zde značí počet podproblémů, faktor, kterým zmenšujeme podproblém a určuje sloučení.
Věta 0.99 (Master). Rekurentní rovnice má pro konstatny řešení:
pokud , pak ,
pokud , pak ,
pokud , pak .
Neboli, problém rozložíme na podproblémů velikosti . Výsledky složíme v .
Na vstupu
prvků, rozdělíme na dvě části
,
,
na konci slijeme. Použijeme Master theorem:
Pro
,
triviálně. Pro
problém dělíme na
podproblémy velikosti
.
Slijeme nakonec dohromady v
.
Celkem tedy
,
a prostor
,
což vyhovuje případu (1) a máme: T(n) =
if then return
if , zkopírujeme zbylá :
if , zkopírujeme zbylá :
Máme dvě čísla
a chceme jejich součin
.
Rozděláme horních
a dolních
cifer.
Platí
, pro čísla
.
Součin pak můžeme spočítat jako:
Což je ovšem stále asymptoticky
.
Můžeme to ale ještě vylepšit – o jeden součin méně – na:
Máme tak
,
což vyhovuje případu (3) a dostáváme tak
.
Definice 0.257 (Vyhledávácí strom). Pro vyhledávací strom platí, že klíč v každém vrcholu je větší než všechny klíče v levém podstromu a je menší než všechny klíče v pravém podstromu.
Definice 0.258 (AVL). Rozdíl v hloubkách stromů
je maximálně jedna. (vyvážený strom)
Hloubka je
(
Find, Insert).
Definice 0.259 (Binární strom). Strom mající nejvýše dva syny.
Notace: kořen/vrchol, levý syn , pravý syn , klíč .
Show –
vypíše všechny prvky |
|---|
if then return
Show()
Vypiš
Show()
Find –
porovná
s předem hledaným klíčem
|
|---|
if then return
if then return
if
then return
Find()
if
then return
Find()
Min –
minimum z prvků |
|---|
if then return
return
Min()
Insert –
vkládáme prvek do stromu |
|---|
if then vytvoříme nový s klíčem
if then pass je již ve stromu
if then
if then
Delete –
odstraníme prvek ze stromu |
|---|
if then return list
if then return existuje pravý syn
if then return existuje levý syn
nahradíme následníka
Primitivní třídící algoritmus. Časová složitost je v nejhorším i průměrném případě.
Je efektivní pro malá pole a téměř seřazená data. Časová složitost je ale stále .
Poznámka 0.6. Insertionsort je vhodný pro malá pole (typicky ) a dosahuje lineární časové složitosti pro téměř seřazená data.
Typický příklad algoritmu rozděl a panuj. Průměrná časová složitost: , v případě špatného výběru pivota ale můžeme dosáhnout . Paměťová složitost je (rekurzivní zásobník).
if
then return
prvky
,
které
prvky
,
které
prvky
,
které
Rekurzivně třídíme části
Věta 0.100. Quicksort je randomizovaný algoritmus, jehož očekávaná časová složitost je při volbě pivota náhodným výběrem.
Věta 0.101 (O složitosti třídění). Každý deterministický algoritmus v porovnávacím modelu, který třídí -prvkovou posloupnost, použije v nejhorším případě porovnání.
Na vstupu máme graf s počátečním vrcholem . Během průchodu grafem rozlišujeme tři možné stavy vrcholů; nenalezené – ještě jsme je nepotkali, otevřené – potkali, ale neprozkoumali hrany, které z nich vedou, a uzavřené – už jsme prozkoumali i hrany, nadále se nezabýváme.
stav
otevřený
Pro DFS ještě definujeme pomocná pole in, out, do kterých zaznamenáme, v jakém pořadí jsme vrcholy otevírali a zavírali.
prázdný
zásobník,
for každý
do
stav
nenalezený
in,
out
nedefinováno
for každý
do
if
stav
nenalezený then
DFS2
return
stav
otevřený
,
in
stav
uzavřený
,
out,
.push.
Poznámka 0.7 (Složitost BFS a DFS). Oba algoritmy pracují v čase a prostoru .
Poznámka 0.8. Algoritmus DFS detekuje cykly a klasifikuje hrany
Acyklické orientované grafy (DAG) lze uspořádat, aby vedly hrany po směru uspořádání.
Definice 0.260 (Topologické uspořádání). Lineární uspořádání na vrcholech grafu je topologické, pokud .
Věta 0.102. Orientovaný graf má topologické uspořádání je DAG.
Věta 0.103. DFS opouští vrcholy v pořadí opařné topologickému.
Pro hledání nejkratší cesty v neohodnoceném grafu můžeme použít BFS/DFS, ale pro ohodnocené grafy otřebujeme větší kanón – Dijsktrův/Bellman-Fordův algoritmus. Dijkstrův algoritmus funguje pouze pro nezáporné hrany, Bellman-Ford i pro záporné.
stav
otevřený
Poznámka 0.9 (Složitost Dijkstrova algoritmu). Časová složitost je nebo s prioritní frontou.
(Bellman-Ford). Čas .
Hledání nejkratší cesty v ohodnoceném orientovaném grafu včetně záporných hran.
Dívám se na hrany a aktualizuji vrcholy.
Fronta podle pořadí otevřených vrcholů můžu otevírat už jednou zavřené vrcholy.
Poznámka 0.10. Dijkstra pracuje pouze s nezáporným ohodnocením, Bellman-Ford i se záporným.
Definice 0.261 (Váha). Váha je funkce . Váha podgrafu je součet vah jeho hran.
Definice 0.262 (Minimální kostra). Kostra grafu je minimální, pokud má mezi kostrami nejmenší váhu.
libovolný vrchol grafu
strom obsahující
a žádné hrany
Poznámka 0.11 (Složitost Jarníkova algoritmu). V každém kroku Jarníkův algoritmus přidá nejlevnější hranu spojující strom s novým vrcholem. Časová složitost je nebo s prioritní frontou
)
Poznámka 0.12 (Složitost Borůvkova algoritmu). Borůvkův algoritmus v každé iteraci přidá nejlevnější hranu z každé komponenty. Zároveň pracuje i s nesouvislými grafy. Časová složitost je . Vhodný pro řídké grafy.
Poznámka 0.13 (Jarník VS Borůvka). Jarník přidává v každém kroku jeden vrchol a pracuje s jedním stromem (souvislý graf). Borůvka naproti tomu přidává více hran najednou a pracuje s více komponentami (nesouvislý graf)
Definice jednotlivých pojmů viz kapitola Teorie grafů (0.4.9).
nulový tok
tok
.
Zlepšující cesta: neorientovaná cesta , kde dopředná hrana má a zpětná .ckem
specifikuje kontrakty třídy – vícenásobná dědičnost.
oddělení interface od implementace.
schopnost jedné reference odkazovat na objekty různých typů.
opětovné použití existující třídy – “extends”.
implementuje interface – třída bude mít definované metody.
člen třídy není vázán na instanci/ objekt, ale na celou třídu.
přístu v rámci třídy a všech podtříd, ale mimo třídu neviditelná.
volání konstruktora předka (rodiče) – když dědí třída.
public interface Animal {
    void makeSound();           // verejna abstraktni metoda
    ...
}

public class Pet {
    protected String name;      // pristupna v ramci tridy a v podtridach
    public void greet() {
        System.out.println("Hello " + name);
    }
}

public class Dog extends Pet implements Animal {    // dedeni a implementace rozhrani
    public Dog(String name) {
        super(name);      // volani predka, pristup k chranenemu atributu z nadtridy
    }

    @Override
    public void makeSound() {   // implementace metody z interface
        System.out.println("Woof");
    }

    @Override
    public void greet() {       // prepsani metody z predka/nadtridy (polymorfismus)
        System.out.println("Dog " + name + " says: Woof!");
    }
}

public class Main {
    public static void main(String[] args) {
        Animal myDog = new Dog("Bob");  // polymorfismus: pouziti rozhrani jako typu
        myDog.makeSound();              // volani metody z interface

        Pet myPet = (Pet) myDog;        // pretypovani na nadtridu
        myPet.greet();                  // volani prepsane metody z predka
    }
}Používají se primárně dva způsoby – Thread a
Runnable.
Thread t = new MyThread();  // vytvorime instanci tridy MyThread
t.start();

public class MyThread extends Thread {  // trida MyThread dedi od tridy Thread
    @Override
    public void run() {                 // prepisujeme metodu run
        System.out.println("Thread is running");
    }
}Runnable r = () -> System.out.println("Runnable is running");
Thread t = new Thread(r); // vytvorime instanci Thread a predame ji instanci Runnable
t.start(); // spustime vlaknoSnaha zajistit, aby “něco” probíhalo pouze v jednom vlákně najednou.
public void increment() {
    synchronized(this) {    // k teto casti kodu se dostane jen jeden thread najednou
        this.count++;
    }
}

// nebo

public synchronized void increment() { // synchronizace cele metody
    this.count++;
}volatile viditelnost hodnoty mezi vlákny.
wait() vlákno se uspí a čeká na probuzení.
notify() probudí čekající vlákno.
notifyAll() probudí všechna čekající vlákna.
AtomicInteger synchronized na steroidech (rychlé, bez blokace).
private volatile boolean running = true;
public void stop() {
    running = false; // bez synchronized, ale s volatile
}

private AtomicInteger count = new AtomicInteger(0);
public void increment() {
    count.incrementAndGet(); // atomicka operace
}// bez lambda funkce:
isEven(x) {
return x % 2 == 0;
}
// lambda funkce:
isEven = x % 2 == 0;
// bez lambda funkce:
for (String name : names) {
System.out.println(name);
}
// lambda funkce:
names.forEach(name -> System.out.println(name));Race condition dvě nebo více vláken přistupuje k datům současně a výsledek závisí na načasování (přepíše se v běhu).
Například:
increment()count++;
– více vláken najednou upravuje count.
Řešení: použít synchronized nebo
AtomicInteger.
Deadlock
dvě a více vláken čekaní na zámky, které se vzájemně drží.
0x1A2B
0x1A2B
“” alespoň 1
“” oboje
“^” právě 1
“” posun k MSB doleva (resp. doprava)
“” opak
Stejně jako celá, ale bit znaménka. (v praxi se nepoužívá)
Jedničkový doplněk: u záporných se prohodí a . Funguje porovnávání i sčítání, akorát máme dvě nuly ().
Dvojkový doplněk: MSB je znaménkový bit. Řeší dvě nuly. Negace je doplněk bitů .
Za pomoci znaménka, exponentu a mantisy.
Příklad: Reprezentace čísla
Číslo je záporné, proto sign bude .
Převedeme .
Převedeme na dvojkovou soustavu:
Výsledek je tedy:
Proces: nezávislá běhová entita v OS. Má vlastní memory space.
Thread: v rámci procesu, sdílí procesovou paměť a “další věci”.
Stránkování: Virtual Address Space je rozdělena do stejných částí (stránek) velikosti . Fyzická Address Space je také rozdělena na stejné velikosti (frame). Platí “1 page = 1 frame”. Také “1 level page = 32 bit”.
více vláken najednou přistupuje ke stejným datům.
Pomůže protected nebo scheduling.
Active: instrukce spuštěné během čekání na přístup.
Passive: část procesu je zablokovaná, dokud není povolen přístup.
SpinLock: active za použití TSL/CAS. Ideální pro krátké čekání – malá latence.
Semaphore: protected counter a fronta na čekání
(threads). Kontroluje přístup ke zdroji mezi více vlákny. Příkazy
UP (++counter), DOWN
(–counter).
Mutex: mutual exclusion. V podstatě semafor s
counterem 1 – konrola, že jen jeden thread přistupuje v čase. Příkazy
LOCK, UNLOCK.
Vzájemné čekání, které vede k zacyklení.
Nutné podmínky k zacyklení:
Mutex – alespoň jeden je exclusive.
Hold & wait – jeden drží žádost pro ten druhý.
No preemption – resources nemůžou být znovu přijaty bez újmy.
Circular wait.
mutex m1, m2;

// Thread1      // Thread2
m1.lock();      m2.lock();
m2.lock();      m1.lock();
m2.unlock();    m1.unlock();
m1.unlock(); m2.unlock();Z následujících témat budou vybrána .
Definice 0.263 (Vytvořující funkce). Vytvořující funkce posloupnosti je funkce proměnné definována jako součet .
| Gen. funkce | Posloupnost | Vzorec |
|---|---|---|
Příklad 0.1 (Použití vytvořujících funkcí k řešení lineárních rekurencí). V několika krocích:
Na vstupu máme rekurentní rovnici pro .
Rovnici vynásobíme . (dostaneme tak )
Přepíšeme jako sumu, tedy .
Sumy si pro zjednodušení rozepíšeme: , apod.
Sumy dáme opět do rovnosti (např. ) a vyjádříme funkci .
Pokud je to potřeba, rozložíme na parciální zlomky.
Rozepíšeme jako mocninnou řadu a získáme explicitní vzorec pro .
Věta 0.104 (Zobecněná binomická věta). Pro platí , pro .
Definice 0.264 (Catalanova čísla). Catalanova čísla udávájí počet binárních stromů s vnitřními vrcholy. Platí , neboli počet korektního uzávorkovaní.
Příklad 0.2 (Odvození Catalanova čísla). Mějme funkci:
Dostáváme tak: , což si můžeme zapsat jako kvadratickou rovnici: Počítáme tak dál a vyjádříme vzorec pro -tý člen:
Věta 0.105 (Odhad faktoriálu). Platí odhad: .
Proof. Rozepíšeme za pomoci vlastností logaritmů jako součet: .
Dolní odhad: Budeme sčítat “schody” nad
křivkou:
Horní odhad: Podobně jako dolní odhad, jen budeme sčítat “schody” pod křivkou:
◻
Věta 0.106 (Odhad kombinačního čísla). Pro platí: .
Proof. Budeme využívat vztahu
Dolní odhad: Nerovnost platí, protože je nejmenší a zbytek je rostoucí posloupnost.
Horní odhad: Nerovnost platí, protože je dolní odhad .
◻
Věta 0.107 (Odhad binomického čísla ). Platí odhad: .
Proof. Definujme a dokažme, že .
Horní odhad:
Dolní odhad:
◻
Definice 0.265 (Klika). Klika v grafu je množina vrcholů, t.ž. každé dva jsou spojené hranou. Největší kliku značíme .
Definice 0.266 (Nezávislá množina). Nezávislá množina v grafu je množina vrcholů, t.ž. žádné dva nejsou spojené hranou. Největší nezávislou množinu značíme .
Definice 0.267 (Ramseyovo číslo).
Věta 0.108 (Ramseyova grafová dvoubarevná). Nechť , potom existuje takové, že ve všech grafech s alespoň vrcholy, platí nebo .
Věta 0.109 (Ramseyova – nekonečná pro dvojice). Pro každé (počet barev) a obarvení existuje nekonečná množina taková, že pro všechny dvojice má stejnou hodnotu.
Důkaz (nekonečnou indukcí). Postupným rozebíráním množiny dojdeme až k hledané množině . Indukci začneme tím, že označíme a nastavíme .
V množině zafixujeme libovolný vrchol , zbylé vrcholy rozdělíme do množin podle barvy hrany, která je spojuje s . Víme, že množina je nekonečná, proto alespoň jedna z uvedených stejnobarevných podmnožin musí být také nekonečná. Tuto množinu označíme za a pokračujeme v indukci.
Nemáme zaručeno, že pokaždé vybereme podmnožinu stejné barvy, podle které jsme vybrali předchozí množinu. Protože je ale indukce nekonečná, alespoň jednu barvu musíme zvolit nekonečněkrát. Vrcholy , které odpovídají této barvě, tvoří hledanou množinu . ◻
Věta 0.110 (Ramseyova – nekonečná pro -tice). Pro každé (počet barev), a obarvení existuje nekonečná množina , taková že pro všechny -tice má stejnou hodnotu.
Věta 0.111 (Ramseyova – konečná pro -tice). Pro každé (počet barev), , existuje t.ž. a obarvení existuje konečná množina velikosti , taková, že pro všechny -tice má stejnou hodnotu.
| 1 | 2 | 6 | 18 |
Věta 0.112. Nechť . Pak platí a z toho4:
Věta 0.113. Nechť . Potom .
Důsledek 0.6. Pro
Extrémální kombinatorika studuje maximální nebo minimální velikosti množin (nebo struktur), které splňují určité vlastnosti, často za podmínek vylučujících jiné konfigurace. Například kolik hran může mít graf bez trojúhelníku.
Definice 0.268. Pro a graf definujeme jako největší na vrcholech v grafu , neobsahující jako podgraf.
Příklad 0.3. Například
Definice 0.269 (Turánův graf). Turánův graf na vrcholech s partitami, značený , je úplný -partitiní graf na vrcholech, jehož partity mají velikosti a . Potom .
Věta 0.114 (Turán).
.
(Neboli, jak by měl vypadat graf s co nejvíce hranami, aby
neobsahoval
jako podgraf).
Definice 0.270 (-uniformní hypergraf). -uniformní hypergraf je dvojice , kde je množina -prvkových podmnožin , tedy .
Definice 0.271. Největší počet hyperhran v -uniformním hypergrafu na vrcholech, v němž žádné dvě hyperhrany nejsou disjunktní.
Poznámka 0.14. Pro , protože neexistují hyperhrany.
Poznámka 0.15. Pro , protože každé dvě množiny z se protínají.
Definice 0.272 (Slunečnice). Slunečnice se středem a lístky je -tice množin taková, že . Tedy .
Věta 0.115 (Erdös-Ko-Rado). Pro libovolné a platí .
Definice 0.273 (Abeceda a slovo). Abeceda je konečná množina symbolů. Slovo délky je posloupnost symbolů. Všechna slova délky je . Velikost kódu značíme .
Definice 0.274 (Hammingova vzdálenost). Pro je Hammingova vzdálenost
Definice 0.275 (Hammingova váha). Hammingova váha . Tedy počet nenulových složek v binárním kódu. Platí, že vzdálenost v bin kódu je rovna nejmenší váze nenulového slova.
Definice 0.276 (Minimální vzdálenost). Minimální vzdálenost pro kód je minimum z Hamingových vzdáleností:
Definice 0.277 (-kód). -kód je množina taková, že a .
Definice 0.278 (Lineární kód). Lineární kód je kód , který je vektorový podprostor . Aby byl kód lineární, musí obsahovat nulové slovo a musí být uzavřený na sčítání.
Definice 0.279 (Generující matice kódu ). Generující matice kódu pro lineární -kód je matice , jejíž řádky tvoří bázi .
Definice 0.280 (Duální kód k “orotgonální doplněk”). Duální kód k je
Definice 0.281 (Kontrolní matice). Nechť je lineární -kód. Kontrolní matice kódu je matice, jejíž řádky tvoří bázi . (“paritní kontroly, které splňují každé slovo").
Definice 0.282 (Hammingovy kódy). Délka , vzdálenost .
Definice 0.283 (Koule). Koule je okolí poloměru kolem v .
Věta 0.116 (Hammingův odhad). Pokud existuje -kód , tak pro a :
Proof. Kolem každého slova
sestrojíme kouli
.
Jelikož
,
tak jsou libovolné dvě koule pro
disjunktní
.
Kdyby se překrývaly, existovalo by z trojúhelníkové nerovnosti slovo
,
že:
což je ale ve sporu s minimální vzdáleností kódu
.
Počet slov je určen mohutností koule, která je dána
.
Jelikož je v kódu
takových disjunktních koulí, tak součet objemů nemůže být větší než
celková počet bin slov délky
,
kterých je
.
Dostaneme tak výsledný vzorec
◻
Definice 0.284 (Perfektní kód). Kód je perfektní, pokud pro něj platí Hammingův odhad s rovností.
Příklad 0.4 (Příklady perfektních kódů). Perfektní kódy jsou například Hammingovy kódy nebo “opakovací kód s lichou délkou”. Triviální kód (pouze nuloví slova).
Definice 0.285 (Dělení). Dělení intervalu je posloupnost , kde
Definice 0.286 (Horní/dolní Riemannovy součty). Pro omezenou funkci a dělení definujeme dolní a horní součty: kde
Definice 0.287 (Horní/dolní Riemannův integrál). Horní a dolní Riemannův integrál přes je:
Definice 0.288 (Riemannův integrál funkce). Riemannův integrál funkce přes je:
Definice 0.289 (-rozměrný kompaktní interval). -rozměrný kompaktní interval (v ) je
Definice 0.290 (Dělení intervalu). Dělení intervalu je posloupnost dělení :
Definice 0.291 (Cihly intervalu). Intervalům
říkáme cihly dělení
.
Množinu všech cihel značíme
.
Je to skoro disjunktní dělení intervalu
.
Různé cihly z
se totiž setkávají jen v podmnožinách okrajů, tedy v množinách objemu 0,
díky čemuž platí:
Definice 0.292 (“Supremum/infimum” na kompaktním intervalu). Je dána omezená na -rozměrném kompaktním intervalu a je -rozměrný kompaktní podinterval intervalu . Položme
Definice 0.293 (Horní/dolní součty). Pro dělení intervalu a omezenou funkci definujeme
Definice 0.294 ((Horní/dolní) Riemannův integrál). Množiny a jsou shora/zdola omezené a můžeme definovat dolní/horní Riemannův integrál funkce přes jako Jsou-li si rovny, máme Riemannův integrál funkce přes , značíme:
Věta 0.117 (Kritérium existence Riemannova integrálu). Riemannův integrál existuje právě když existuje dělení takové, že
Věta 0.118 (Riemannův integrál pro spojité funkce). Každá spojitá funkce na -rozměrném kompaktním intervalu má Riemannův integrál .
Věta 0.119 (Fubiniova věta). Vezměme součin intervalů , . Nechť existuje a nechť pro každé , resp. , existuje Potom je
Definice 0.295 (Parciální derivace). Pro funkci a bod definujme funkci Parciální derivace5 funkce podle proměnné v bodě je (obvyklá) derivace funkce v bodě Značíme ji:
Definice 0.296 (Totální diferenciál). Funkce má totální diferenciál v bodě a, existuje-li funkce spojitá v okolí bodu taková, že a čísla pro která S použitím skalárního součinu jde též zapsat jako
Lemma 0.1 (Spojitost, parciální derivace a totální diferenciál). Nechť má funkce totální diferenciál v bodě a. Potom je spojitá v a, a má všechny parciální derivace v a s hodnotami
Věta 0.120 (Spojité parciální derivace a totální diferenciál). Nechť má spojité parciální derivace v okolí bodu a. Potom má v a totální diferenciál.
| Pravidlo | Vzorec pro parciální derivaci | Příklad |
|---|---|---|
| Součet | ||
| Násobení | ||
| Dělení | ||
| Chain rule |
Věta 0.121 (O záměnnosti). Mějme funkci takovou, že existují parciální derivace a , které jsou spojité v nějakém okolí bodu . Potom:
Věta 0.122 (Lagrangeova věta ve více proměnných). Nechť má spojité parciální derivace v konvexní otevřené množině . Potom pro libovolné dva body takové, že: kde (konvexní kombinace ) a je gradient funkce .
Mějme funkci .
Najdeme stacionární body tak, že položíme první parciální derivace rovny nule:
V těchto bodech vyšetříme druhé derivace pomocí Hessiánu:
Typ extrému určíme pomocí kritéria pozitivní/negativní definitnosti Hessiánu:
pozitivně definitní lokální minimum, (v pokud a )
negativně definitní lokální maximum, (v pokud a )
indefinitní sedlový bod. (v pokud )
Věta 0.123. Pokud je spojitá na kompaktní množině , pak dle Weierstrassovy věty nabývá na svého maxima i minima.
Věta 0.124 (Nutná podmínka pro lokální extrém). Mějme funkci . Pokud má v bodě lokální extrém, potom platí jedna z podmínek:
, nebo derivace neexistuje.
Bod je na hranici .
Věta 0.125 (Postačující podmínka pro extrém). Mějme funkci , bod uvnitř a dále platí, že jsou spojité v , a (podezřelý z extrému). Pak:
Pokud je pozitivně definitní, pak nabývá v lokálního minima.
Pokud je negativně definitní, pak nabývá v lokálního maxima.
Pokud je indefinitní, pak v nenabývá lokálního extrému.
Tato matice se nazývá Hessova matice a značí se .
Cílem je hledat extrémy nějakého zobrazení na nějaké omezené množině .
Věta 0.126 (O hledání extrému funkcí s vazbami).
Buďte
reálné funkce definované na otevřené množině
.
Nechť mají spojité parciální derivace. Nechť je hodnost matice
maximální, tedy
,
v každém bodě oboru
.
Jestliže funkce
nabývá v bodě
lokálního extrému podmíněného vazbami
Pak existují čísla
,
Lagrangeovy multiplikátory, taková, že
platí
nebo ekvivalentně přes gradienty jako
Nechť a . Podle věty hledáme Máme tři rovnice o třech neznámých. Určíme , a máme , nebo (pro ). Dosadíme do a dopočítáme . Následně dosadíme body do a zjistíme, že v bodech nabývá maxima, v bodech nabývá minima a body dávají a nejsou tudíž extrémy.
Definice 0.297 (Metrický prostor). Nechť je množina, funkce taková, že platí:
(trojúhelníková nerovnost)
pak je metrický prostor.
Příklad 0.5. Metrické prostory jsou například: , .
Definice 0.298 (Euklidovský prostor ). Definujeme jako metrický prostor , kde : Pro nás zvlášť důležitý, známý v podobě vektorového prostoru se skalárním součinem a normou a vzdáleností
Definice 0.299 (Diskrétní prostor). Definujeme jako , kde pro
Definice 0.300 (Podprostor). Buď metrický prostor. Pak je podprostor, kde a .
Definice 0.301 (Okolí). Nechť je metrický prostor, pak : Formulaci se říká otevřená koule s poloměrem okolo .
Definice 0.302 (Otevřená množina). je otevřená, pokud je okolím každého svého bodu, neboli
Definice 0.303 (Uzavřená množina). Nechť . Pokud každá posloupnost má , pak a nazveme uzavřenou množinou. (Alternativě, pokud je otevřená.)
Příklad 0.6. Uvážíme-li interval s Euklidovskou metrikou, pak
je pouze uzavřený …()
je také pouze uzavřený …( lim na konvergující v mají lim v )
je pouze otevřený. …(Např , ale .)
je jak otevřený, tak uzavřený
Definice 0.304 (Spojité zobrazení). je spojité zobrazení, pokud
Definice 0.305 (Konvergence). Posloupnost v metrickém prostoru konverguje k , pokud
Věta 0.127 (Složení spojitých zobrazení je spojité). Pokud jsou a spojité, pak je spojité i .
Věta 0.128 (Věta o konvergenci). Zobrazení je spojité pro každou konvergentní v , posloupnost konverguje v a platí .
Definice 0.306 (Kompaktní množina). Množina je kompaktní, pokud je uzavřená a omezená.
Definice 0.307 (Kompaktní metrický prostor). Metrický prostor je kompaktní, pokud každá posloupnost v něm obsahuje konvergentní podposloupnost.
Věta 0.129 (Extrémy spojité funkce na kompaktním prostoru). Buď kompaktní. Potom každá spojitá funkce nabývá minima i maxima (t.j. nejsou nekonečné).
Definice 0.308 (Stejnoměrná spojitost). Řekneme, že je stejnoměrně spojitá, pokud
V porovnání s definicí normální spojitosti je rozdíl v pozici kvantifikátorů (v definici spojitosti jsou na úplném začátku). To odpovídá tomu, že pro spojitost požadujeme okénko pouze pro jeden bod a ne pro celou funkci, jak je tomu u stejnoměrné spojitosti.
Geometrický význam je ten, že pro libovolnou vzdálenost v existuje t. ž. okénko o velikosti umístěné do libovolného místa v grafu není grafem protnuto nahoře ani dole. Na obrázku 0.1 je vidět, že funkce stejnosměrnou spojitost splňuje, kdežto funkce nikoliv.
Věta 0.130 (Spojitost zobrazení na kompaktním prostoru). Pokud je kompaktní, pak je každé spojité zobrazení stejnoměrně spojité.
Začneme s rekurzivním algoritmem, který je exponenciálně pomalý. Odhalíme opakované výpočty stejných podproblémů. Uděláme si tabulku (cache), do které zapisujeme, které podproblémy jsme už vyřešili. Cache lze vyplňovat bez rekurze, zvolíme vhodné pořadí podproblémů. Získáme tak stejně rychlý, ale jednodušší algoritmus. (Topologicky uspořádáme DAG).
Chceme najít podposloupnost která je ostře rostoucí. Problém si
nejprve rozdělíme na hledání počtu prvků (největší možný).
Nechť
je délka Nejdelší Rostoucí Podposloupnosti začínající prvkem
.
Rekurze se můžeme zbavit a tabulku vyplňovat postupně od největšího k nejmenšímu. Budeme tedy počítat , což bude délka nejdelší ze všech rostoucích podposloupností začínajících .
délka
Máme následující edatační operace: změna/ vložení/ smazání jednoho
znaku.
Definujme
jako délku nejkratší posloupnosti editačních operací, která převede
na
.
Platí následující podmínky:
Pokud :
Změna na :
Vložení :
Smazání :
Celkem tak máme
,
a :
Otočíme směr výpočtu a tabulku s výsledky podproblémů budeme vyplňovat bez použití rekurze. Představíme-li si ji jako matici, každý prvek závisí pouze na těch, které leží napravo a dolů od něj. Tabulku proto můžeme vyplňovat po řádcích zdola nahoru, zprava doleva. Tím získáme jednodušší algoritmus, který běží v čase .
for
do
.
for
do
.
.
Nechť je orientovaný graf a jsou relace na vyznačující:
je hrana z do ,
je .
Definice 0.309 (Silná souvislost). Říkáme, že graf je silně souvislý relace má komponentu.
Definice 0.310 (Komponenty silné souvislosti). Podgrafy indukované třídami .
Definice 0.311 (Graf komponent). Pro graf definujeme graf komponent jako:
,
.
Sestrojíme
prázdný zásobník
Opakované DFS na
,
při opouštění vrcholu přidáme do
Pole
Definice 0.312 (Průtok). Průtok definujeme pro tok jako: .
Definice 0.313 (Síť rezerv). Síť rezerv k toku v síti je síť , kde je rezerva hrany při toku . Rezerva je .
Definice 0.314 (Blokující tok). Pokud na každé orientované -cestě , .
Definice 0.315 (Vrstevnatá síť). Síť je vrstevnatá (pročištěná), pokud všechny její vrcholy a hrany leží na nejkratších cestách ze do .
Začne s nulovým tokem a bude ho vylepšovat pomocí nějakých pomocných toků v síti rezerv, až se dostane k maximálnímu toku. Počet potřebných iterací přitom bude záviset na tom, jak vydatné pomocné toky seženeme – na jednu stranu bychom chtěli, aby byly podobné maximálnímu toku, na druhou stranu jejich výpočtem nechceme trávit příliš mnoho času. Vhodným kompromisem jsou blokující toky.
tok .
nulový tok
tok .
Lemma 0.2 (O korektnosti). Pokud se algoritmus zastaví, vydá maximální tok.
Lemma 0.3. V každém průchodu Dinicova algoritmu vzroste alespoň o 1.
Hledá maximální toku v síti. Je jednodušší než Dinicův algoritmus a má po pár snadných úpravách stejnou, nebo dokonce lepší časovou složitost.
Goldbergův algoritmus začne s ohodnocením hran, které ani nemusí být tokem, a postupně ho upravuje a zmenšuje, až se z něj stane tok, a to dokonce tok maximální.
Definice 0.316 (Vlna). Funkce je vlna v síti , splňuje-li obě následující podmínky:
(vlna nepřekročí kapacity hran),
(přebytek ve vrcholech je nezáporný).
Každý tok je tedy vlnou, ale opačně tomu tak být nemusí. V průběhu výpočtu se tedy potřebujeme postupně zbavit nenulových přebytků ve všech vrcholech kromě zdroje a spotřebiče. K tomu bude sloužit následující operace:
Definice 0.317 (Převedení přebytku). Převedení přebytku po hraně můžeme provést, pokud a . Proběhne tak, že po hraně pošleme jednotek toku, podobně jako v předchozích algoritmech buď přičtením po směru nebo odečtením proti směru.
Rádi bychom postupným převáděním všechny přebytky přepravili do spotřebiče, nebo je naopak přelili zpět do zdroje. Chceme se ovšem vyhnout přelévání přebytků tam a zase zpět, takže vrcholům přiřadíme výšky –- to budou nějaká přirozená čísla .
Přebytek pak budeme ochotni převádět pouze z vyššího vrcholu do nižšího. Pokud se stane, že nalezneme vrchol s přebytkem, ze kterého nevede žádná nenasycená hrana směrem dolů, budeme tento vrchol zvedat –- tedy zvyšovat mu výšku po jedné, než se dostane dostatečně vysoko, aby z něj přebytek mohl odtéci.
Nastavíme počáteční výšky:
pro všechny
Vytvoříme počáteční vlnu:
všude nulová funkce
, kdykoliv
Maximální tok .
Mějme nějaký bipartitní graf . Přetvoříme ho na síť následovně:
Nalezneme partity grafu, levou a pravou.
Všechny hrany zorientujeme zleva doprava.
Přidáme zdroj a vedeme z něj hrany do všech vrcholů levé partity.
Přidáme stok a vedeme do něj hrany ze všech vrcholů pravé partity.
Všem hranám nastavíme jednotkovou kapacitu.
Najdeme maximální celočíselný tok a jelikož , musí po každé hraně téci buď nebo . Do výsledného párování vložíme právě ty hrany původního grafu, po kterých teče .
Nechť je délka jehly, délka sena. Dále budeme pracovat s následujícími pojmy:
Podslovo .
Prefix , Suffix .
Stav algoritmu: Očíslovány , Nejdelší prefix jehly, který je zároveň suffixem sena.
Dopředná funkce: Rozšíření prefixu přidáním jednoho symbolu .
Zpětná funkce přiřadí jeho nejdelší suffix různý od , který je prefixem jehly.
Aalgoritmus pro hledání jednoho vzoru v textu. Stavy očíslujeme .
Nejprve spočítáme prefix funkci (pole nejdelších vlastních prefixů, které jsou zároveň sufixy).
Při prohledávání textu využíváme prefixovou funkci k tomu, abychom se při neúspěchu nemuseli vracet, ale abychom přeskočili části textu, kterou už jsme porovnali.
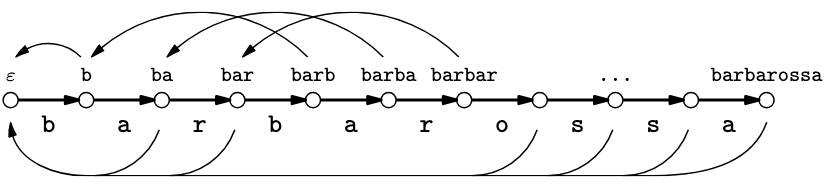
while
do
.
if
then
.
Hledání více řetězců najednou v textu.
je počet výskytů v seně
.
Máme
s délkami
a seno
délky
.
Definice 0.318 (Zkratková hrana). Řekne, jaký je nejdelší vlastní suffix slova , který je jehlou.
Stav automatu – Všechny možné prefixy slov. Kořen slov je .
Zpet() – Vede ze stavu do nejdelšího suffixu řetězce , který je stavem.
Zkratka() – Ukazuje nejbližší stav dosažitelný po zpětných hranách, ve kterém končí nějaké z hledaných slov.
Slovo() – Zda tu končí nějaké slovo (a pokud ano, tak které),
Dopředu() – Ze stavu vede dopředná hrana označená znakem do nového stavu. Tím se aktuální prefix prodlouží o znak.
Algoritmus probíhá následovně:
Nejprve vytvoříme trie (prefixový strom) všech vzorů.
Pak přidáme tzv. fail odkazy mezi uzly pro přechod při neúspěchu.
Nakonec procházíme text znak po znaku a sledujeme přechody v automatu, přičemž při každém kroku víme, zda právě skončil některý z hledaných vzorů.
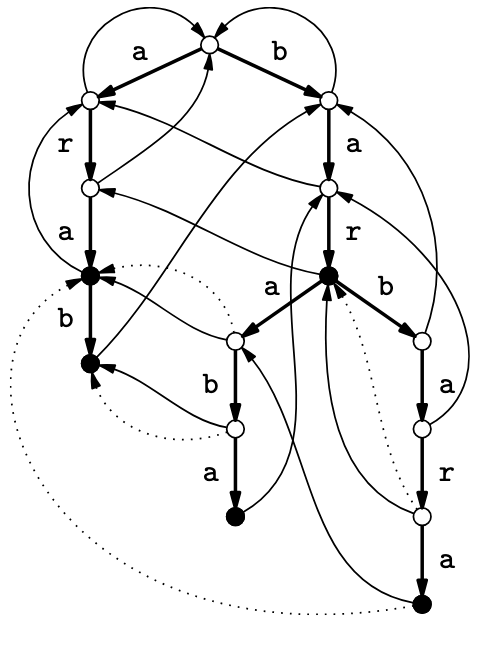
if
Dopredu
then
Dopredu
koren
zalozime strom s korenem
vkladame do stromu slovo Dopredu, Slovo
Zpet
fronta, vlozime do ni syny korene
synum korene nastavime zpetnou hranu na koren, neboli Zpet
Poznámka 0.16. Pro připomenutí. Pracujeme s různými tvary komplexních čísel:
Algebraický tvar: , dále .
Goniometrický tvar: .
Exponenciální tvar: Eulerova formule .
Definice 0.319 (Primitivní -tá odmocnina z ). Číslo je primitivní -tá odmocnina z , pokud a žádné z čísel není rovno .
Poznámka 0.17. Pro sudé
je
.
Platí totiž
,
takže
je druhá odmocnina z
.
Takové odmocniny jsou jenom dvě:
a
,
ovšem
to být nemůže, protože
je primitivní.
Definice 0.320 (Diskrétní Fourierova transformace (DFT)). Diskrétní Fourierova transformace je zobrazení , které vektoru přiřadí vektor daný předpisem kde je pevně zvolená primitivní -tá odmocnina z jedné. Vektor se nazývá Fourierův obraz vektoru .
Definice 0.321 (Fourierova Transformace). Fourierova transformace vektoru je dána maticovým násobením: kde je Fourierova matice.
Definice 0.322 (Inverzní Fourierova Transformace IFFT). Inverzní Fourierova transformace je: což odpovídá maticovému násobení s komplexně sdruženou maticí :
Věta 0.131 (Vlastnosti Fourierovy matice). Fourierova matice splňuje , kde je jednotková matice řádu .
Poznámka 0.18 (Výpočet IFFT). Pro praktický výpočet IFFT použijeme stejný algoritmus FFT, ale:
Místo použijeme (nebo ekvivalentně ).
Výsledek nakonec vydělíme .
Zadefinujeme si:
| velká prvočísla, t.ž.: | |
| dvojice, veřejný klíč, kde | |
| Eulerova funkce | |
| šifrovací exponent | |
| dešifrovací exponent |
Zároveň musí plati platit
a dále se hodí k výpočtům následující vztahy:
| zašifrování plaintextu, výsledkem je ciphertext | |
| dešifrování ciphertextu, výsledkem je plaintext | |
| .. | získání (Euklidovým algoritmem) |
Dešifrování se dá lehce odvodit: .
Bob si vygeneruje nahodná a vypočítá z nich . Dále vypočítá Eulerovu funkci a následně vygeneruje číslo , pro které platí . Tímto číslem zašifruje plaintext vztahem . Pak už jen nalezne číslo euklidovým algoritmem . Veřejný klíč, dvojici , pošle Alici spolu s ciphertextem .
Alice přijme veřejný klíč a ciphertext . Pouze Alici je znám soukromý klíč , využije ho k dešifrování . To udělá vztahem .
Eva nemá možnost si zprávu přečíst, protože nezná dešifrovací exponent . Musela by ho uhádnout, což není pravděpodobné, nebo by musela znát prvočísla . Kdyby znala mohla by si jednoduše dopočítat a následně tak, jak jsme to udělali my. Bezpečnost RSA tedy stojí na tom, že útočník není schopen rozložit na , proto je potřeba je volit dostatečně velká.
Máme nějakou množinu přípustných řešení a každé z nich ohodnoceno cenou . Mezi nimi hledáme optimální řešení s minimální cenou . Vystačíme si s -aproximací – přípustné řešení má cenu pro .
Definice 0.323 (Poměrová chyba). Poměrová chyba je poměr mezi výstupem a optimem je nejvýše .
Definice 0.324 (Relativní chyba). Relativní chyba nepřekročí .
Definice 0.325 (PTAS - Polynomial-Time Approximation Scheme). Algoritmus je PTAS, pokud najde v čase polynomiálním v (velikost vstupu), řešení s relativní chybou nejvýše . Formálně: kde je optimální řešení a je řešení algoritmu.
Definice 0.326 (FPTAS - Fully Polynomial-Time Approximation Scheme). Algoritmus je FPTAS, pokud je PTAS a navíc jeho časová složitost je polynomiální jak v , tak v . Formálně: kde je nějaký polynom.
Příklad 0.7. Problém batohu má FPTAS. Problém TSP v obecných grafech má PTAS, ale ne FPTAS.
Poznámka 0.19. FPTAS je silnější požadavek než PTAS, protože vyžaduje polynomiální závislost na , ne jen na .
Definice 0.327 (Problém TSP). Mějme neorientovaný graf s nezáporně ohodnocenými hranami . Cílem je najít nejkratší hamiltonovskou kružnici v . Předpokládáme, že graf je úplný a splňuje trojúhelníkovou nerovnost:
Najdi minimální kostru
grafu
.
Projdi kostru Eulerovským sledem (délka
).
Odstraň duplicity ve vrcholech pomocí “zkratek” (využitím trojúhelníkové
nerovnosti).
Poznámka 0.20. Výsledná délka kružnice je , kde je délka optimálního řešení.
Věta 0.132. Bez trojúhelníkové nerovnosti nelze TSP aproximovat (pokud ).
Definice 0.328 (Problém batohu). Mějme batoh s kapacitou a množinu předmětů s:
Hmotnostmi ,
Cenami .
Cílem je najít podmnožinu takovou, že:
Odstraň všechny předměty s
.
Spočítej
a zvol
pro libovolné
.
Kvantujeme ceny: pro
nechť
.
Vyřešíme upravený problém batohu s
dynamickým programováním.
Vrátíme předměty z optimálního řešení kvantovaného problému.
Poznámka 0.21. Zaokrouhlování hmotností by mohlo vést k nepřípustným řešením, ale zaokrouhlování cen je bezpečné.
Věta 0.133. Algoritmus poskytuje -aproximaci v čase .
Definice 0.329 (Komparátorová síť). Komparátorová síť je hradlová síť složená z komparátorů. Na vstupu má čísla a výstopem je vlevo menší číslo, vpravo větší číslo.
Příklad 0.8 (Bubble sort ). Příkladem je Bubble sort, který jsme schopni udělat lineární:
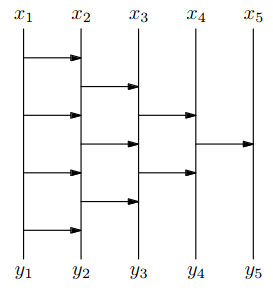
Definice 0.330 (Čistá bitonická posloupnost).
Posloupnost
je čistě bitonická, pokud existuje index
takový, že:
(rostoucí část)
(klesající část)
Definice 0.331 (Bitonická posloupnost). Posloupnost je bitonická, pokud je cyklickou rotací nějaké čistě bitonické posloupnosti.
Definice 0.332 (Separátor). Separátor je obvod, který:
Rozdělí bitonickou posloupnost délky na dvě poloviční posloupnosti.
Zajistí, že všechny prvky v první polovině jsou menší než všechny prvky v druhé polovině.
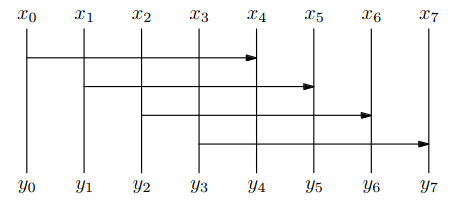
Platí následující vlastnosti:
Hloubka obvodu: 1 (jedna vrstva komparátorů)
Počet hradel: ( komparátor 2 vstupy a 2 výstupy)
Časová složitost:
Poznámka 0.22. Za pomoci bitonických “třídiček” a “slévaček” jsme takto schopni vytvořit jednoduše Merge stort. (viz. Obr.)
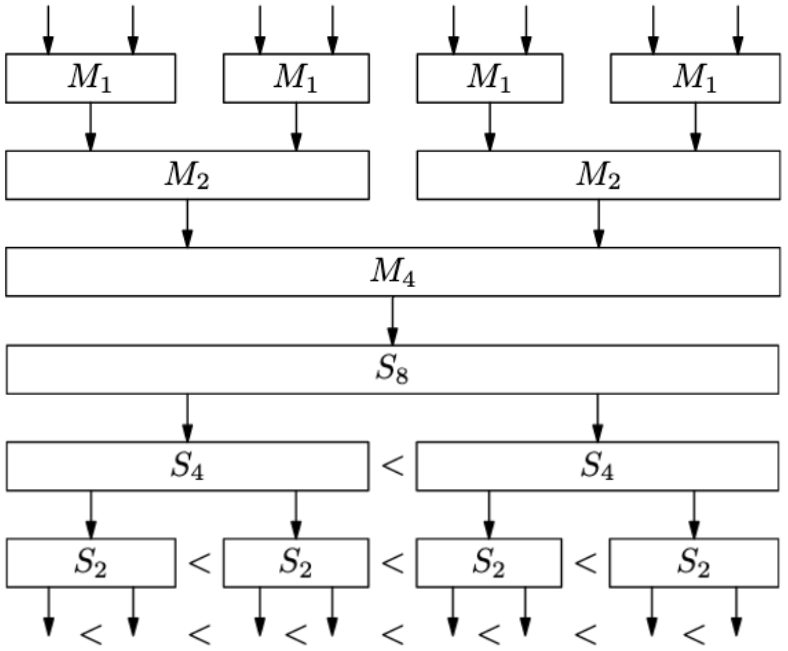
Definice 0.333 (Lineární program). Lineární program (LP) v kanonickém tvaru je následující optimalizační úloha daná maticí a vektory , :
Celočíselný LP je program, kde a standardní (rovnicový) tvar je .
Věta 0.134. Každou úlohu LP lze převést na standardní tvar.
Proof.
Rovnice na nerovnice:
Nerovnice na rovnice:
Nezáporné na neomezené proměnné: přidáme podmínky nezápornosti jako nerovnice
Neomezené na nezáporné proměnné:
◻
Definice 0.334 (Báze matice). Nechť je matice s hodností . Báze matice je množina indexů sloupců taková, že a podmatice je regulární, tedy .
Definice 0.335 (Množina přípustných řešení). Množina přípustných řešení je množina
Definice 0.336 (Bázické řešení). Bázické řešení je , pokud existuje báze matice taková, že pro každé .
Poznámka 0.23. Každé bázi přísluší nejvýše jedno bázické řešení.
Poznámka 0.24. Řešení je bázické sloupce matice , kde , jsou lineárně nezávislé.
Věta 0.135. Je-li účelová funkce s alespoň jedním přípustným řešením shora omezená na množině přípustných řešení, potom existuje bázické řešení splňující .
Definice 0.337 (Konvexní mnohostěn a vrchol). Konvexní mnohostěn je průnikem konečně mnoha poloprostorů: .
Bod je vrchol, pokud existuje takové, že pro každé .
Věta 0.136. Nechť a . Potom je vrchol je přípustné bázické řešení.
Definice 0.338 (Dualita). Nechť . Pro LP (P) definujeme duální úlohu (D) následovně:
,
.
Věta 0.137 (Slabá věta o dualitě). Nechť a jsou přípustná řešení (P) a (D), pak .
Věta 0.138 (Silná věta o dualitě). Pro (P) a (D) platí právě jedno z následujících:
(P) ani (D) nemají přípustné řešení,
(P) je neomezená, (D) nemá přípustné řešení,
(D) je neomezená, (P) nemá přípustné řešení,
(P) i (D) mají přípustné, tedy i optimální řešení pro (P) a pro (D) a platí .
Důsledek 0.7 (Podmínky komplementarity). Nechť je přípustné řešení (P) a je přípustné řešení (D). Potom jsou optimální
, nebo , kde
, nebo , kde
Poznámka 0.25. Podmínky komplementarity lze zapsat také jako a . To znamená, že pokud je v jedné úloze omezení splněno s ostrou nerovností, musí být v druhé úloze odpovídající proměnná rovna nule.
Lemma 0.4 (Farkasovo). Nechť a nechť . Pak nastane právě jedna z následujících:
Soustava má nezáporné řešení pro nějaké ,
takové, že .
Definice 0.339 (Konvexní kužel). Konvexní kužel generovaný se definuje
Lemma 0.5 (Farkasovo geometricky). Mějme libovolné vektory , pak nastane právě jedna za následujících možností:
Bod
Existuje nadrovina procházející bodem , t.j. pro nějaké , taková že všechny vektory (tedy i celý ) leží na jedné její straně, tj. pro všechna , a leží na straně druhé (ostře), tj. .
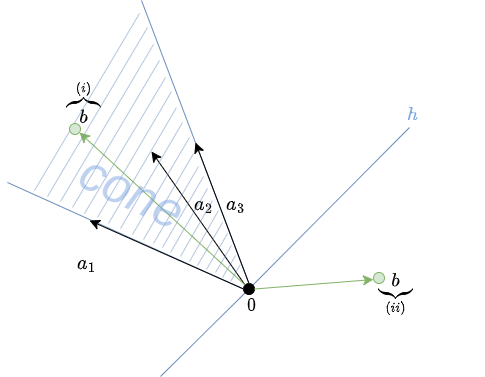
Geometricky to znamená, že buď leží v konvexním kuželu generovaném sloupci , nebo existuje oddělující nadrovina.
Simplexová metoda iterativně přechází mezi bázickými přípustnými řešeními, která odpovídají vrcholům mnohostěnu.
Definice 0.340 (Simplexová tabulka). Simplexová tabulka určená přípustnou bází je soustava lineárních rovnic pro proměnné a , která má stejnou množinu řešení jako soustava , a v maticovém zápisu vypadá takto: kde je vektor bázických proměnných, , je vektor nebázických proměnných, , , je matice typu a .
Poznámka 0.26. Řešení je přípustné . Řešení je optimální .
V každém kroku vstupuje do báze proměnná s kladnou redukovaným cenou a vystupuje proměnná, která jako první dosáhne nuly.
Definice 0.341 (Pivotovací krok). Máme bázi, kterou upravíme na .
Vstupující proměnná: , že .
Vystupující proměnná: , že a .
Úprava tabulky: Převedeme na levou stranu a dosadíme.
Pokud neexistuje vstupující proměnná
je optimální.
Pokud neexistuje vystupující proměnná
úloha je neomezená (viz. Pozorování).
Pokud existují, tak je bazí matice , protože elementárními řádkovými úpravami dostaneme z . Platí tedy, že existuje a .
Poznámka 0.27. Pokud je sloupec matice indexovaný , pak je úloha neomezená.
Definice 0.342 (Dantzigovo pravidlo). Pro vstupující proměnnou a vystupující vybereme s maximální a zvolíme libovolně z množiny proměnných.
Tedy vybíráme do báze proměnnou s nejzápornějším (při maximalizaci) nebo nejkladnějším (při minimalizaci) redukovaným koeficientem v řádku účelové funkce.
Definice 0.343 (Degenerované řešení). Bázické
přípustné řešení
se nazývá degenerované, pokud více než
složek vektoru
je rovno nule.
Ekvivalentně, alespoň jedna bázická proměnná
je rovna nule, tedy v tabulce
.
Simplexová metoda může cyklit pouze v případě degenerace, proto se hodí Blandovo pravidlo, které je sice pomalé, ale necyklí.
Definice 0.344 (Blandovo pravidlo). Pro vstupující proměnnou a vystupující vybereme nejmenší možné a pro něj vybereme nejmenší možný index .
Tedy vybíráme vstupující i vystupující proměnnou s nejmenším indexem.
Definice 0.345 (Konvexní obal). Konvexní obal množiny , značíme , je průnik všech konvexních množin obsahujících , tedy Alternativně je to množina všech konvexních kombinací bodů z :
Definice 0.346 (Afinní obal). Afinní obal množiny je průnik všech afinních prostorů obsahujících .
Definice 0.347 (Afinní kombinace). Afinní kombinace je bod , kde (koeficienty mohou být záporné).
Věta 0.139 (Minkowski-Weyl). Množina je omezený konvexní mnohostěn existuje konečná množina bodů taková, že
Věta nám říká, že i když máme obrovské množství bodů (třeba všechna přípustná párování v grafu), jejich konvexní obal je pořád jen nějaký objekt popsaný konečným počtem nerovnic. Problém je obvykle v tom, že těch nerovnic může být exponenciálně mnoho vzhledem k počtu bodů, proto se využívají metody řezů nebo separace.
Definice 0.348 (Unimodulární matice). Matice s lineárně nezávislými řádky je unimodulární, pokud je celočíselná a pro každou bázi platí .
Definice 0.349 (Totálně unimodulární matice). Matice je totálně unimodulární (TU), pokud každá její čtvercová podmatice má determinant roven nebo .
Věta 0.140. Nechť je celočíselná s , pak platí, že
Věta 0.141. Nechť je celočíselná a má lineárně nezávislé řádky, potom je celočíselné pro každé je unimodulární.
Věta 0.142 (Hoffman-Kruskal). Nechť je celočíselná. Mnohostěn je celočíselný pro každé je totálně unimodulární.
Věta 0.143. Matice incidence orientovaného grafu je totálně unimodulární. Matice incidence neorientovaného grafu je TU je graf bipartitní.
Věta 0.144 (Königovo lemma). V libovolném bipartitním grafu je velikost maximálního párování rovna velikosti minimálního vrcholového pokrytí.
Nyní uvedeme reprezentaci toků v sítích za pomoci LP, následně vytvoříme duál a ukážeme si souvislost s unimodularitou.
Vstup: orientovaný graf, kapacity hran, zdroj a stok.
Cíl: Maximální tok z do .
Definujme si tok hranou a přebytek ve vrcholu jako:
To je ale moc složité – zjednodušíme přidáním hrany nekonečné kapacity.
Tok cirkuluje – měříme kolik teče na umělé hraně .
Duál lineárního programu 2:
Poznámka 0.28. Incidenční matice tohoto LP je totálně unimodulární.
Poznámka 0.29. Optimální duální řešení pro toky má kombinatorický význam: pokud definujeme , pak hrany s tvoří minimální řez. Podmínka zajišťuje, že a jsou v různých komponentách.
Věta 0.145. Pokud jsou celočíselné, tak existuje celočíselný maximální tok.
Věta 0.146 (Max-Flow Min-Cut). V každé tokové síti je velikost maximálního toku rovna kapacitě minimálního řezu.
Tato věta je přímým důsledkem duality LP aplikované na TU matici incidence grafu.
Primárně-duální algoritmus využívá podmínek komplementarity: hrana může být v optimálním párování pouze pokud .
(Primárně-duální algoritmus). Pokud je přípustné řešení (P) a pro (D), pak
Definice 0.350 (Graf rovnosti). Pro duální řešení definujeme graf rovnosti , kde .
Poznámka 0.30. Primárně-duální algoritmus pak hledá maximální párování v . Pokud není perfektní, upraví se duální ceny tak, aby do přibyla nová hrana.
(Vážené maximální perfektní párování). Lze řešit pomocí LP a jeho duálu:
(P) Primární úloha
(D) Duální úloha
Postupně upravujeme , kde je párování v a je přípustné řešení (D).
Začátek:
Konec:
je perfektní
je optimum (P). To vychází z podmínek komplementarity.
Definice 0.351 (Celočíselný mnohostěn). Mnohostěn je celočíselný má všechny vrcholy celočíselné.
Definice 0.352 (Racionální mnohostěn). Mnohostěn je racionální a všechny složky i jsou racionální.
Věta 0.147. Nechť je racionální, potom všechny vrcholy jsou racionální .
Věta 0.148. Mnohostěn je celočíselný platí, že je celé číslo.
Definice 0.353 (Celočíselný obal). Pro mnohostěn definujeme jeho celočíselný obal jako: Obecně platí . Cílem je často najít popis pomocí lineárních nerovnic.
Definice 0.354 (Chvátalův řez). Nechť . Pro mnohostěn a vektor takový, že je celočíselný, se podmínka nazývá Chvátalův řez.
Každý celočíselný bod z tento řez splňuje, ale některé neceločíselné vrcholy jím mohou být odříznuty.
Definice 0.355 (Chvátalův uzávěr). . Tedy je průnik se všemi možnými řezy.
Věta 0.149. Chvátalův uzávěr je racionální mnohostěn.
Opakováním tohoto procesu lze pro každý racionální mnohostěn získat jeho celočíselný obal .
Věta 0.150. Nechť je racionální mnohostěn, , je splněno . Potom existuje důkaz podmínky , pro .
Věta 0.151. existuje důkaz podmínky “ ”.
(Metoda větvení a mezí). Rozdělujeme prostor hledání na podproblémy (větve). Využíváme LP relaxaci k určení horní meze (pro maximalizaci) kvality řešení v dané větvi.
Větvení: Pokud v optimu relaxace vyjde např. , rozdělíme úlohu na: a .
Ořezávání: Pokud je horní mez v dané větvi horší než nejlepší dosud nalezené celočíselné řešení, větev dále nezkoumáme.
Celočíselné programování se využívá tam, kde rozhodnutí mají diskrétní charakter. Tedy například v kombinatorických úlohách (TSP, Knapsack, Scheduling), v modelování podmínek typu “pokud vybereme A, musíme vybrat i B” pomocí binárních proměnných, nebo v modelování situací, kdy samotné zahájení aktivity stojí fixní částku.
Definice 0.356 (Matroid). Matroid je dvojice , kde je konečná množina a (nezávislé množiny) splňující:
.
. (Dědičnost)
. (Výměnný axiom)
Poznámka 0.31. Axiomy (3) je ekvivalentní s axiomem: Nechť a jsou maximálně nezávislé (vzhledem k inkluzi). Potom .
Definice 0.357 (Báze). Báze matroidu je libovolná maximální nezávislá množina vzhledem k inkluzi.
Poznámka 0.32 (Průnik matroidů). Mějme dva matroidy a na stejné nosné množině. Jejich průnik obecně není matroid (např. Hamiltonovská cesta v grafu).
Pro dva matroidy existuje polynomiální algoritmus (Edmons) pro nalezení největší společné nezávislé množiny. Pro tři a více je problém nalezení maximální společné nezávislé množiny NP-těžký.
Matroidy zobecňují pojem nezávislosti z lineární algebry a teorie grafů. Zde jsou základní příklady:
Vektorový (lineární) matroid: Nechť je konečná množina vektorů z nějakého vektorového prostoru a je systém lineárně nezávislých podmnožin . Tato dvojice tvoří matroid, kde nezávislost odpovídá lineární nezávislosti.
Grafový matroid (cyklický): Mějme graf . Definujeme a patří do podgraf neobsahuje žádnou kružnici (tedy je les). Báze v souvislém grafovém matroidu odpovídají kostrám grafu.
Fanova rovina: Jedná se o nejmenší projektivní rovinu (7 bodů, 7 přímek). Prvky jsou body Fanovy roviny. Nezávislé množiny jsou ty trojice bodů, které neleží na společné přímce.
Definice 0.358 (Řádová funkce). Pro matroid definujeme řádovou funkci jako velikost největší nezávislé podmnožiny dané množiny:
Věta 0.152 (Ekvivalentní definice matroidu pomocí ). Funkce je řádovou funkcí nějakého matroidu pro každé a splňuje:
,
, (jednotkový nárůst)
. (vlastnost lokální submodularity)
Věta 0.153 (Submodularita řádové funkce). Řádová funkce libovolného matroidu splňuje:
,
, (monotonicita)
. (submodularita)
Tedy matroidy jsou přesně ty systémy, kde je řádová funkce monotónní a submodulární.
Definice 0.359 (Duální matroid). Nechť je matroid. Jeho duální matroid je definován tak, že množina nezávislá v je ta, jejíž doplněk v obsahuje bázi původního : Ekvivalentně lze říci, že množina je báze je báze .
Věta 0.154 (O duálu duálu). Pro každý matroid platí, že duál jeho duálu je původní matroid: .
Věta 0.155 (Řádová funkce duálního matroidu). platí, že řádová funkce duálního matroidu je dána vztahem:
Definice 0.360 (Cyklus). Cyklus je minimální závislá množina vzhledem k inkluzi.
Definice 0.361 (Uzavřená množina). Množina se nazývá uzavřená, pokud platí, že přidáním k vzroste hodnost: .
Definice 0.362 (Kocyklus a kobáze). Kocyklus je cyklus . Kobáze je báze (tedy doplněk báze ).
Existuje silná souvislost mezi operacemi v grafech a vlastnostmi jejich grafových matroidů.
Věta 0.156 (Cykly a řezy). Nechť je graf a jeho grafový matroid. Pro množinu hran platí, že je kocyklem je minimální řez v grafu .
Důsledek 0.8. Pokud je rovinný graf a je jeho rovinný duál, pak .
Je dán systém s nezápornou váhovou funkcí . Cílem je najít nezávislou množinu , která maximalizuje celkovou váhu . Předpokládejme, že prvky jsou seřazeny sestupně podle vah: .
for to do
if then
return
Věta 0.157. Nechť je dědičný systém. Hladový algoritmus řeší úlohu maximalizace váhy pro každou nezápornou váhovou funkci je matroid.
Důsledek 0.9 (Edmonds). Nechť je množina charakteristických vektorů nezávislých množin matroidu . Potom , kde je matroidový polytop definovaný jako:
Definice 0.363 (Optimalizační problém). Optimalizační problém definujeme jako , kde:
je množina všech vstupů/instancí,
je množina přípustných řešení,
je účelová funkce,
je bit určující, zda chceme maximalizovat nebo minimalizovat
Definice 0.364 (NP-Optimalizační problém). NP-Optimalizační problém definujeme jako , pro které platí stejné vlastnosti jako pro normální optimalizační problémy, ale navíc:
Délka přípustných řešení .
Jazyk dvojic je v (rychle umíme ověřit, zda je řešení přípustné).
je počitatelná v polynomiálním čase.
Definice 0.365 (R-aproximace (poměr)). Algoritmus je -aproximační, pokud:
V polynomiálním čase v na vstupu najde .
Pro minimalizační problém: .
Pro maximalizační problém: .
Definice 0.366 (Aproximační schéma). PTAS je rodina algoritmů, kde pro každé existuje -aproximační algoritmus v čase .
(Obchodní cestující - TSP). Dostaneme úplný ohodnocený graf. Cílem je najít nejmenší Hamiltonovský cyklus.
Poznámka 0.33. Pro obecný TSP neexistuje -aproximační algoritmus pro žádné (pokud ). Pokud však platí trojúhelníková nerovnost, mluvíme o metrickém TSP, který aproximovat lze.
Definice 0.367 (Zkracování). Zkracování je metoda, díky které vracíme vždy jen první výskyt vrcholu v eulerovském tahu. (Například .)
Najdi minimální kostru .
Zdvojnásob každou hranu a najdi Eulerovský tah .
Vypiš Hamiltonovský cyklus po zkracování.
Věta 0.158. Algoritmus Metric TSP je -aproximační.
Proof. Víme, že (jinak vynecháním hrany z dostaneme kostru menší než naše nejmenší kostra ). Výsledný cyklus je díky zkracování . Jelikož obsahuje každou hranu dvakrát, tak . Tedy . ◻
Najdeme minimální kostru a označme vrcholy lichého stupně .
Najdeme minimální perfektní párování na
Najdeme Eulerovský tah a proveď zkracování.
Vypíšeme vzniklý cyklus .
Věta 0.159. Christofidesův algoritmus je -aproximační.
Proof. Víme, že . Zároveň víme, že (viz. Obr.), proto:
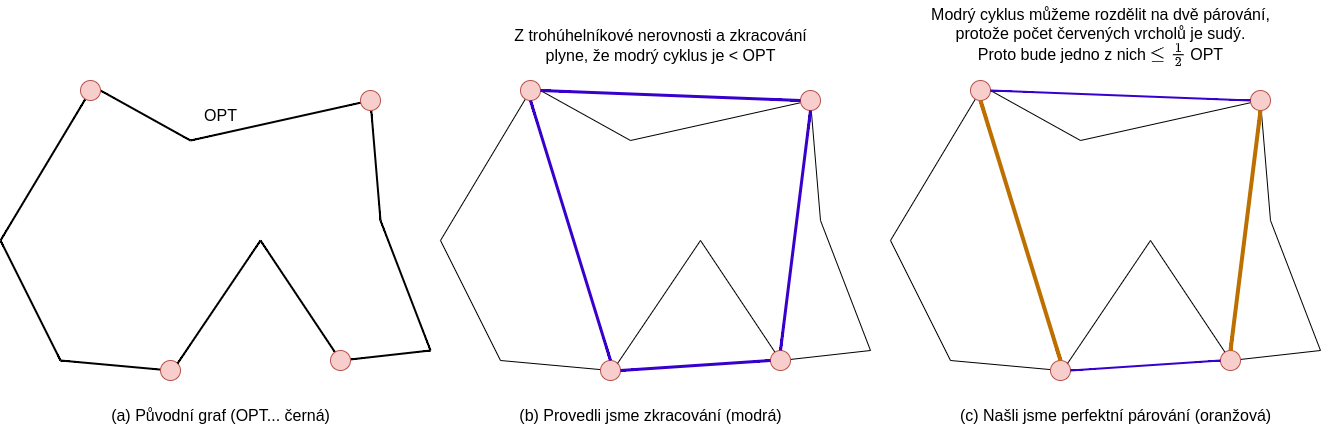
◻
(Rozvrhování (Scheduling)). Každá úloha může být zpracována jen na jednom ze strojů a každý stroj může zpracovávat nejvýše jednu úlohu najednou.
Vstup: strojů, úloh, každá trvá .
Výstup: Rozvržení úloh stroje. Rozklad množiny (disjunktní).
Cíl: , neboli minimalizovat délku rozvrhu.
Pro a úlohu definujme:
je čas začátku úlohy
je čas konce úlohy
, neboli délka rozvrhu
Začni s nějakým rozvrhem.
if
Přeřaď úlohu na stroj s minimální dobou dokončení.
else return aktuální rozvrh.
Opakuj krok 2.
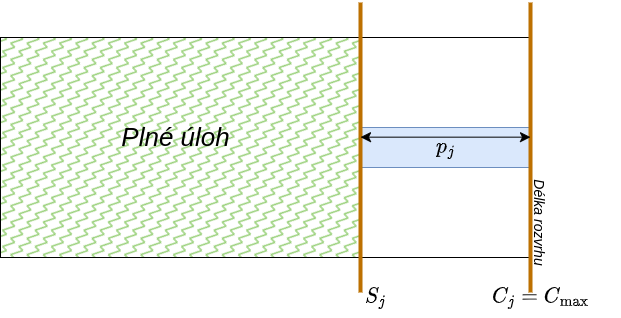
Věta 0.160. Algoritmus Lokální prohledávání rozvrhu je -aproximační.
Libovolně uspořádej úlohy
Zpracovávej úlohy jednu po druhé a přiřaď úlohu na nejméně načtený stroj
Věta 0.161. Algoritmus List scheduling – Hladový je -aproximační.
Úlohy uspořádáme tak, že .
Použijeme hladový List Scheduling algoritmus.
Věta 0.162. Algoritmus LPT je -aproximační.
(Množinové pokrytí). Hledáme minimální pokrytí množiny.
Vstup: Systém množin , každý má cenu , kde
Výstup: Podsystém , že .
Cíl: , tedy minimalizovat cenu .
Vybereme na začátku množinu pokrývající nejvíc prvků. A pak vybíráme takovou, která pokrývá nejvíce nových prvků. Tedy abychom si za stejnou cenu koupili co nejvíc.
while
Pro polož .
Buď , že je minimální.
Buď .
.
return
Věta 0.163. Algoritmus je -aproximační.
(MAX-SAT).
Vstup: boolovských proměnných a klauzulí s vahou .
Výstup: Hodnota True/False vzhledem k
Cíl: maximalizovat váhy příslušných klauzulí, tedy
Předpokládáme, že se žádný literál v klauzuli neopakuje a že nejvýše jeden z se vyskytuje v
for nezávisle náhodně nastav
Věta 0.164. Algoritmus RAND-SAT je -aproximační.
Nechť a nechť je množina klauzulí bez záporných jednotkových klauzulí.
for nezávisle náhodně nastav
Věta 0.165. Algoritmus BIASED-SAT je -aproximační, kde .
Nyní si uvedeme algoritmus LP-SAT, který relaxuje úlohu na LP, vyřeší ji a nastaví proměnné na True s pravděpodobností rovnou jejich hodnotě v LP optimu. Sestavíme LP:
Pro každou proměnnou si pořídíme binární proměnnou a pro každou klauzuli binární proměnnou .
Vytvoř lineární program (viz. LP níže)
Relaxuj program a vyřeš ho (dostaneme optimum )
Nastav proměnné na True s pravděpodobností a False s .
Věta 0.166. Algoritmus LP-SAT je -aproximační
S pravděpodobností
spusť RAND-SAT, s pravděpodobností
spusť LP-SAT.
Věta 0.167. Algoritmus BEST-SAT je -aproximační.
(Vrcholové pokrytí).
Vstup: Graf , ceny vrcholů .
Výstup: , že .
Cíl: , minimalizujeme ceny.
Lineární program
Poznámka 0.34. je vrcholové pokrytí je nezávislá množina.
Poznámka 0.35. Vrcholové pokrytí je speciálním případem množinového pokrytí, kde a je maximální stupeň grafu. ( si uvedeme později).
Vytvoř celočíselný lineární program (viz. LP níže).
Zrelaxuj program a vyřeš ho: , tedy , když .
Věta 0.168. Algoritmus Vertex-Cover je -aproximační.
Proof. Proměnné jsme během relaxace zaokrouhlili z na . Tím jsme řešení max zdvojnásobili. ◻
(Množinové pokrytí).
Vstup: Systém množin , každý má cenu , kde
Výstup: Podsystém , že .
Cíl: , tedy minimalizovat cenu .
Můžeme si to představit jako bipartitní graf, kde levá partita obsahuje a pravá . Potom máme parametry:
, tedy maximální stupeň na levé partitě, (maximální frekvence prvku),
, tedy maximální stupeň na pravé partitě.
Vytvoř celočíselný lineární program (viz. LP níže).
Zrelaxuj program a vyřeš ho: , tedy zvol , když .
Lineární program
Duální program
Věta 0.169. Algoritmus LP-Set Cover je -aproximační.
Proof. Proměnné jsme během relaxace zaokrouhlili z na . Řešení jsme násobili max -krát: ◻
Pokud jsou a optima, pak z podmínek komplementarity:
while
for all a
return
Věta 0.170. Algoritmus PDA je -aproximační.
Proof. ◻
(Globální minimální řez). Na vstupu dostaneme neorientovaný graf a na výstupu bude řez . Cílem je minimalizovat velikost řezu .
Převedeme graf na ohodnocený s jednotkovými kapacitami.
Zafixujeme vrchol .
Pro všechny ostatní vrcholy najdeme minimální -řez.
return minimum z nich.
Algoritmus na párech počítá minimální -řez (v ). Proto celkem .
Vyber uniformě náhodně hranu a její vrcholy zkontrahujeme do jednoho.
Opakujeme, dokud nemáme pouze dva vrcholy.
Zbylé hrany na konci jsou náš řez.
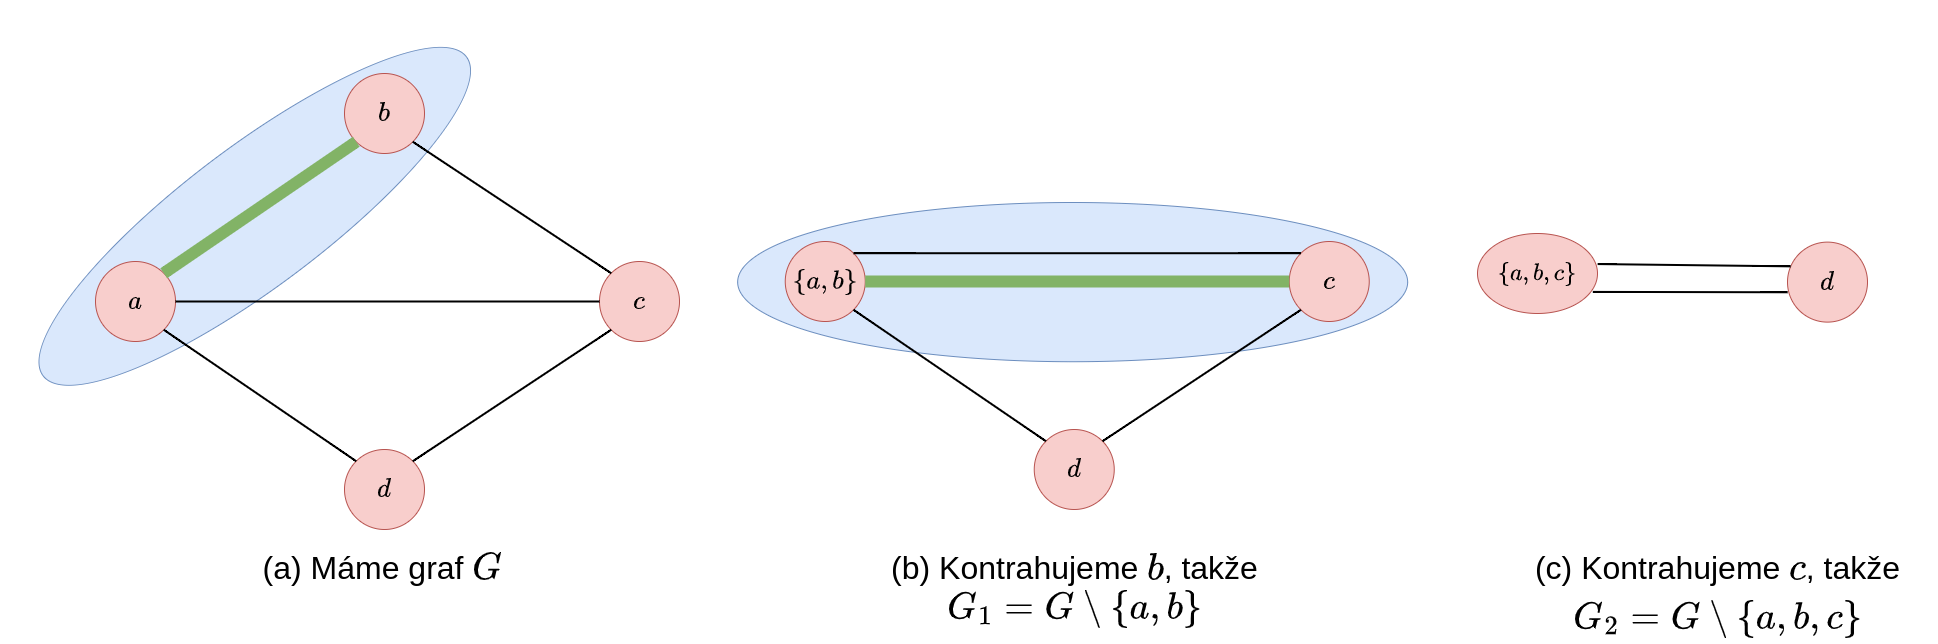
Zůstaly 2 vrcholy, mezi nimi 2 hrany, to je velikost globálního minimálního řezu .
Poznámka 0.36. Během kontrakce hran odstraňujeme vzniklé smyčky, ale ponecháváme násobné hrany. Počet násobných hran mezi zbylými dvěma vrcholy na konci algoritmu určuje velikost řezu.
Poznámka 0.37. Každý řez v odpovídá řezu v .
Poznámka 0.38. Pokud je řez v a , pak je řez v .
Lemma 0.6. Multigraf s vrcholy a minimálním řezem velikosti má alespoň hran.
Věta 0.171. Pravděpodobnost, že najdeme daný minimální řez je alespoň
Důsledek 0.10. Každý graf má nejvýše globálních minimálních řezů.
Věta 0.172. Pro opakování algoritmu dostaneme nejmenší řez s pravděpodobností .
Proof. ◻
Důsledek 0.11. Celkový počet globálních minimálních řezů je .
Definice 0.368 (2-univerzálnost). Nechť . Systém je
-univerzální, jestliže:
silně -univerzální, jestliže:
Poznámka 0.39. Silná -univerzalita slabá -univerzalita.
Poznámka 0.40. Silná -univerzalita po nezávislé náhodné proměnné.
Máme univerzum velikosti , slovník velikosti a cílem je reprezentovat tabulkou velikosti . je silně 2-univerzální, volíme uniformě náhodně.
Kolize řešíme za pomoci spojového seznamu řetězením za sebe.
(trvá průměrně ):
vložení do
vyhledávání v
vymazání z
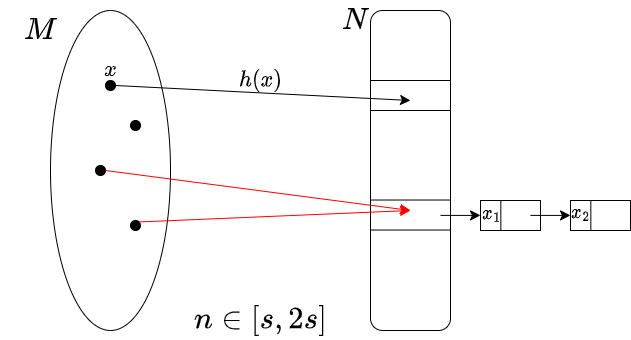
Lemma 0.7. Pokud , tak průměrná doba operace je
Lemma 0.8. , pokud je silně 2-univerzální, kde je množina kolizí pro .
Oproti dynamickému slovníku, statický využívá dvouúrovňové hashování. První úroveň rozdistribuuje prvků do slotů tak, aby suma . Druhá pro každý slot s prvky vytvoří tabulku o velikosti . Pravděpodobnost kolize v takto velké tabulce je , což umožňuje v průměru na druhý pokus najít perfektní hashování pro daný slot.
je dáno předem. Vytvoříme datastrukturu v polynomiálním čase. Chceme, aby prostor byl velikosti a aby operace vyhledání běžela nejhůř v čase .
(to jsme předtím neměli – seznam mohl být dlouhý a maximální počet operací velký)
Vybereme tak, že , kde je kolize.
Vytvoříme dvě tabulky a hashujeme dvakrát – jednou pro index do první tabulky () a ta určí funkci pro druhé hashování ().
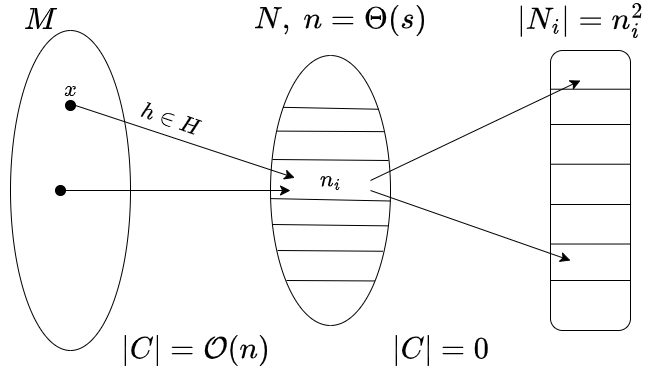
Lemma 0.9. Existuje s .
Proof. . ◻
Lemma 0.10. Existuje s .
Proof. . ◻
Lemma 0.11.
Proof. . ◻
(Maticové testování). Testujeme rovnost pomocí náh. vektoru : v čase
Vstup: Matice
Výstup: ANO, pokud , jinak NE.
Vezmi náhodný vektor
if return ANO
else return NE
Věta 0.173. Pokud , pak .
Poznámka 0.41. Algoritmus trvá kroků a řekne ANO .
(Nulovost polynomů (PIT)). Identita se testuje vyhodnocením v náhodném bodě. Pravděpodobnost chyby je , kde je stupeň polynomu.
Vstup: Matice polynomů proměnných, determinant určuje náš polynom
Výstup: ANO, jestliže je polynom identicky nulový, jinak NE
Nezajímá nás, jestli je identicky nulový, ale zda je nulový v tělese, ve kterém pracujeme. Budeme pracovat s polynomy více proměnných a bude označovat celkový stupeň.
Převeditelné na to, zda je výrok tautologie (jdou na sebe převést) NP těžké.
Lemma 0.12. Nechť je nenulový polynom nad tělesem stupně a konečná množina. Nechť uniformě náhodně. Pak Pro má polynom nejvýše kořenů, ať zvolíme jakkoliv.
Poznámka 0.42. Podle si volíme přesnost algoritmu (pro máme ).
Algoritmus pro hledání maximální nezávislé množiny (Lubyho) využívá náhodné priority k eliminaci sousedů. V průměru skončí v fázích.
(PARA-MIS).
Vstup: Graf
Výstup: maximální nezávislá množina vzhledem k inkluzi
Vybereme velkou nezávislou množinu . Z grafu odebereme spolu se všemi incidentními hranami. Zde značí množinu sousedů.
while
for all : pokud je pak , .
for all : označ s pravděpodobností (nezávisle).
for all : pokud i jsou označeny, smaž označení nižšího stupně.
odeber hrany incidentní s vrcholem v .
return , pokud .
Definice 0.369 (Dobrý vrchol). Vrchol je dobrý, pokud má sousedů stupně . Jinak špatný.
Definice 0.370 (Špatná hrana). Hrana je špatná, pokud jsou oba její vrcholy špatné.
Lemma 0.13. Existuje konstanta , že dobrý platí v jedné iteraci . 6
Lemma 0.14. Špatných hran je nejvýše . (Respektive, alespoň polovina hran je dobrá.)
Věta 0.174. Průměrný počet fází algoritmu je .
Definice 0.371 (Edmondsova matice). Nechť je bipartitní graf, . Pak Edmondsova matice grafu je matice definována předpisem
(Za každou hranu bude v matici jedna proměnná.)
Poznámka 0.43. je polynom, jehož monomy bijektivně odpovídají perfektním párovaním.
(sčítáme součin permutace matice a když se zrovna trefíme do párovaní, tak máme monom)
Zvol uniformně náhodně nezávisle ,
Spočítej determinant.
if determinant then párování určitě existuje.
else párování neexistuje s pravděpodobností
Nyní si uvedeme Izolující lemma. To zaručuje, že při náhodném vážení hran existuje právě jedno PP s minimální vahou. To umožňuje paralelní výpočet determinantů Edmondsovy matice v čase polylogaritmickém.
Věta 0.175 (Izolující lemma). Nechť máme systém množin s náhodně zvolenými vahami . Pak7 Zde je počet hran a rozsah vah. Pro naše použití budeme chtít
Zvol rovnoměrně náhodně váhy pro každou hranu.
Zasubstituuj do Edmondsovy matice .
Najdi tak, že je maximální číslo tvaru , že .
for
Spočítej , kde vzniklo odstraněním řádku a sloupce z .
if je max. číslo tvaru then přidej do
Zkontroluj, že je PP
(*) V algoritmu příspěvek PP je
(**) Zajímá nás poslední index, kde , jelikož to odpovídá unikátnímu perfektnímu párování. (všechny PP jsou ve tvaru , kde jsou nuly za )
Definice 0.372 (Vrcholová barevnost). Vrcholová barevnost grafu je nejmenší počet barev, kterými lze obarvit vrcholy . (Tedy žádné dva sousední vrcholy nemají stejnou barvu).
Poznámka 0.44. Pro graf
značíme:
Maximální stupeň jako ,
Minimální stupeň jako ,
Velikost největší kliky jako ,
Velikost největší nezávislé množiny jako .
Věta 0.176. Pro graf platí vztah: .
Definice 0.373 (Degenerovanost). Graf je -degenerovaný každý podgraf grafu má .
Poznámka 0.45. Pokud je -degenerovaný, pak .
Definice 0.374 (Hranové barvení). Hranové barvení je funkce (barvy) taková, že pokud a mají společný vrchol, pak .
Definice 0.375 (Hranová berevnost). Hranová barevnost (“chromatický index”) je minimální počet barev pro hranové barvení .
Poznámka 0.46. -regulární graf hranově obarvitelný -barvami každá barva tvoří perfektní párování.
Věta 0.177 (Brooks). Nechť je souvislý graf který není úplný a není lichá kružnice. Pak
Proof. Indukcí na počtu vrcholů: pokud má graf vrchol stupně , odebereme ho a zpětně snadno dobarvíme. Pokud je -regulární, najdeme “třešničku”:
Odebereme , dobarvíme barvami. Pokud a mají různé barvy, tak lze dobarvit rovnou. Pokud mají stejnou barvu, barvy přeházíme tak, aby se uvolnila barva pro . Výjimkou, kdy to selže, je jen úplný graf nebo lichá kružnice. ◻
Věta 0.178 (Vizing). Pro každý graf platí, že
Proof. První nerovnost zjevně. Druhá, postupujeme hladově – každou hranu barvíme postupně jednou z barev. Dále rozdělíme na případy; hledáme volné a použitelné vrcholy. Pokud u koncových vrcholů není volná barva, tak pomocí přehazování barev na alternativních řetězcích vždy uvolníme vhodnou barvu. ◻
Poznámka 0.47. Platí, že . A také .
Definice 0.376 (Perfektní graf). Graf je perfektní, pokud .
Věta 0.179 (Slabá o perfektních grafech). Graf je perfektní je perfektní.
Věta 0.180 (Silná o perfektních grafech). Graf je perfektní ani neobsahuje jako indukovaný podgraf lichý cyklus délky .
Poznámka 0.48. Perfektní grafy jsou například , bipartitní grafy nebo chordální grafy.
Definice 0.377 (Chordální graf). Graf je
chordální, pokud neobsahuje
jako indukovaný podgraf.
(každá kružnice má chordu (tětivu))
Definice 0.378 (Párování). Párování je množina hran taková, že každý vrchol je incidentní s nejvýše jednou hranou v . Tedy .
Definice 0.379 (Největší párování). Největší párování je párování největší velikosti. Velikost je nejvýše .
Definice 0.380 (Perfektní párování). Perfektní párování je párování, kde každý vrchol je incidentní s právě jednou hranou. (Neboli pokud v párování neexistuje žádný volný vrchol. .)
Poznámka 0.49. Grafy s lichým početem vrcholů nemají perfektní párování.
Poznámka 0.50. -regulární bipartitní graf lze rozložit na -perfektních párování.
Definice 0.381 (Tutteho podmínka). Platí , kde značí počet lichých komponent grafu.
Věta 0.181 (Tutte). Graf má perfektní párování platí Tutteova podmínka.
Proof. Obměnou „“:. Říkáme, že pokud neplatí Tutteho podmínka, pak nemá perfektní párování.
Nechť t. ž. . V perfektním párování se alespoň vrchol z každé liché komponenty musí spárovat s nějakým z , ale těch není dostatek. ◻
Věta 0.182 (Petersen). Každý -regulární -souvislý8 graf má perfektní párování.
Proof. Vezměme si libovolnou
.
Ukážeme, že splňuje Tutteho podmínku.
Pokud
,
jsme hotovi.
Předpokládejme, tedy že v
existuje lichá komponenta
.
Potom platí:
Počet hran mezi
a
musí být alespoň
,
jinak máme most, je to tedy alespoň
.
Maximální počet hran z
je
,
tudíž lichých komponent může být nejvýše
,
tedy
. ◻
Definice 0.382 (Volný vrchol). Volný vrchol je vrchol, který nevidí žádnou hranu párování.
Definice 0.383 (Střídavá cesta). Střídavá cesta je cesta, kde jsou všechny vnitřní vrcholy incidentní s párovací hranou a navíc tato hrana leží na cestě.
Definice 0.384 (Volná střídavá cesta). Volná střídavá cesta je taková střídavá cesta, jejíž koncové vrcholy jsou volné.
Definice 0.385 (Kytka). Kytka je tvořena stonkem a květem:
stonek je střídavá cesta z (i nulové) délky končící volným vrcholem.
květ je lichá “střídavá” kružnice s vrcholem , ke kterému přiléhají dvě hrany .
(Edmondsův). Na vstupu párování a zlepší jej nebo jej prohlásí za největší.
Hledáme střídavé cesty, které zvyšují velikost .
Pokud narazíme na kytku, zkontrahuje ji do jednoho supervrcholu.
Kytka se rekurzivně zpracuje a po nalezení párování ve sbaleném grafu se rozbalí zpět do původní struktury.
Definice 0.386 (Homeomorfismus). Nechť
.
Potom homeomorfismus z
na
je funkce
,
která je spojitá, bijekce a
je spojitá.
Říkáme, že
jsou homeomorfní,
,
pokud mezi nimi existuje homeomorfismus.
Definice 0.387 (Plocha). Plocha je kompaktní (uzavřená, omezená), souvislá, -rozměrná varieta bez hranice (dostatečně malé okolí každého bodu je homeomorfní otevřenému okolí v ).
Definice 0.388 (Křivka). Křivka v prostoru je spojité zobrazení . Prostá křivka se sama neprotíná.
“Teleport, do kterého když vejdeme, tak na druhé straně vyjdeme
opačně (otočeně).”
Vyřízneme dva kruhy, vezmeme plášť válce bez dna a vrchu, ohneme a
přilepíme na díry po kruzích.
“Teleport, do kterého když vejdeme, tak nás to přesune naproti.”
Definice 0.389 (Orientovaná plocha). Pro nechť značí plochu zvniklou ze sféry přidáním uší, tak říkáme, že je orientovatelná plocha rodu . ( sféra, torus, dvojitý torus)
Definice 0.390 (Neorientovaná plocha). Pro nechť značí plochu vzniklou ze sféry přidáním křížítek, tak říkáme, že je neorientovatelná plocha rodu . ( projektivní rovina)
Definice 0.391 (Nakreslení grafu). Nakreslení grafu na plochu je zobrazení t. ž.:
každému vrcholu přiřadí bod
každé hraně přiřadí prostou (neprotínající se) křivku spojující konce
vrcholy se nepřekrývají:
hrany se překrývají nejvýše ve sdílených vrcholech:
vrcholy, které neleží na hraně se s ní neprotínají:
Definice 0.392 (Stěna nakreslení). Souvislá komponenta .
Definice 0.393 (Buňkové nakreslení). Každá stěna je homeomorfní otevřenému kruhu v .
Definice 0.394 (Eulerova charakteristika). Eulerova charakteristika plochy je
Věta 0.183 (Zobecněná Eulerova formule). Nechť máme nakreslení grafu na ploše , které má stěn. Pak . Pokud je buňkové, tak dokonce .
Důsledek 0.12. Každý graf nakreslitelný na plochu splní , pokud .
Věta 0.184. Nechť
je plocha,
a nechť
je graf nakreslený na
.
Potom
obsahuje vrchol stupně
.
Poznámka 0.51. Platí vztah .
Definice 0.395 (Minor). Nechť jsou grafy. Pak je minor (resp. obsahuje jako minor), značíme , pokud lze získat z posloupností mazání vrcholů, mazání hran nebo kontrakcí hran.
Pro grafové minory platí následující vlastnosti:
je transitivní (prostě spojím posloupnosti operací),
podgraf minor ,
rovinný jeho minory jsou také rovinné. (Platí i pro jiné plochy.)
Věta 0.185 (Kuratowski). rovinný neobsahuje dělení ani jako podgraf.
Věta 0.186 (Kuratowski-Warner). rovinný neobsahuje ani jako minor.
Definice 0.396 (Třída). Pokud je formule, tak výraz nazýváme třídový term. Definuje “soubor” všech množin , pro které platí . Tomuto souboru říkáme třída určená formulí .
Poznámka 0.52. Každá množina je zároveň i třídou, protože .
Definice 0.397 (Vlastní třída). Třídu, která
není množinou, nazýváme vlastní třída.
Vlastní třídou jsou například:
,
třída všech bijekcí mezi
,
.
Definice 0.398 (Třídové operace). Pro třídy
a
definujeme
,
,
,
,
,
, … je podtřídou
, … je vlastní podtřídou
.
Definice 0.399 (Kartézský součin). Kartézský součin tříd a je třída Kartézský součin tříd definujeme induktivně jako
Lemma 0.15. Jsou-li a množiny, potom je také množina.
Definice 0.400 (Binární relace). Binární relace je libovolná třída . Namísto píšeme . Podobně lze definovat -ární relaci jako .
Definice 0.401. Pro (binární) relaci a třídu definujeme třídy
, …inverzní relace k relaci
, …definiční obor relace
, …obor hodnot relace
, …zúžení relace na třídu
. …obraz třídy relací
Definice 0.402. Relace odpovídající relačním symbolům jazyka teorie množin jsou
, …náležení
. …identita
…identita na třídě
Definice 0.403 (Skládání relací). Pro relace a definujeme relaci
Definice 0.404 (Zobrazení). Relace je zobrazení (funkce) Namísto píšeme , při definování píšeme .
Poznámka 0.53. je zobrazení .
Definice 0.405 (Prosté zobrazení, bijekce). Řekneme, že zobrazení je
prosté je zobrazení, tedy …injekce
zobrazení třídy do třídy , píšeme ,
na , tedy …surjekce
bijekce mezi třídami a je to prosté zobrazení na .
Definice 0.406 (Suma). Pro každou množinu existuje množina , která je sjednocením všech množin uvnitř . Této množině říkáme suma množiny a značíme ji .
Definice 0.407 (Potenční množina). Pro každou množinu existuje množina všech jejích podmnožin. Této množině říkáme potenční množina množiny a značíme ji .
Definice 0.408 (Ekvivalence). Relace je na třídě ekvivalence je reflexivní, symetrická a tranzitivní.
Definice 0.409 (Třídy ekvivalence). Nechť je ekvivalence na třídě . Pro definujeme třídu kterou nazýváme ekvivalenční třída prvku .
Definice 0.410. Pro množiny a definujeme relace
existuje bijekce , stejná mohutnost
existuje prosté zobrazení , subvalence
.
Věta 0.187 (Cantor, Schröder, Bernstein). .
Definice 0.411 (Tarski – konečnost). Množina je konečná každá neprázdná má maximální prvek vůči inkluzi. Pokud je konečná, tak píšeme .
Poznámka 0.54. Množina je konečná každá má minimální prvek vůči inkluzi.
Lemma 0.16. Je-li konečná a nekonečná, potom .
Definice 0.412 (Spočetnost). Množina je
spočetná ,
nejvýše spočetná je spočetná nebo konečná,
nespočetná není nejvýše spočetná.
Věta 0.188. Platí
každá shora omezená podmnožina je konečná,
každá shora neomezená podmnožina je spočetná.
Věta 0.189. Jsou-li spočetné množiny, pak a jsou také spočetné.
Věta 0.190. Množiny jsou spočetné.
Věta 0.191 (Cantor). Pro každou množinu platí .
Důsledek 0.13. Množina je nespočetná.
Věta 0.192. .
Věta 0.193. Množiny a nejsou ekvivalentní.
Důkaz. (Spočetnost
).
Nechť
(čitat., jmenov., sign).
je injektivní:
.
je injektivní z jednoznačnosti prvočíselného rozkladu. Podle
Cantor-Schröder–Bernstein věty existuje bijekce
.
Proof. (Cantorovou diagonální metodou).
Víme, že
a
.
Pro spor předpokládejme, že existuje bijekce
.
Tedy všechna reálná čísla v tomto intervalu lze zapsat jako nekonečně
dlouhý očíslovaný seznam prvků
.
Nyní sestrojíme nové reálné
číslo
takto:
.
Tímto jsme zajistili, že
se liší od každého
alespoň v
-té
cifře. Tedy
pro všechna
.
Přitom ale
,
takže mělo být v seznamu, což je spor. ◻
Definice 0.413 (Uspořádání). Relace je na třídě
trichotomická , …porovnatelnost
ostré uspořádání je ireflexivní a tranzitivní na ,
uspořádání je reflexivní, slabě antisymetrická a tranzitivní na ,
lineární uspořádání je trichotomická a uspořádání na .
Pokud je uspořádání, tak místo píšeme . Pro ostré uspořádání píšeme .
Definice 0.414. Nechť je uspořádání na třídě a . Prvek je
horní mez třídy , …také majoranta
maximální prvek třídy ,
největší prvek třídy a je to horní mez ,
supremum třídy je nejmenší prvek třídy všech horní mezí .
Největší prvek, resp. supremum značíme , resp. ; pokud existují. Obdobně definujeme minorantu, minimální prvek, nejmenší prvek a infimum.
Definice 0.415. Řekneme, že uspořádání je na množině
husté ,
dobré každá neprázdná má nejmenší prvek,
úplné každá neprázdná, shora omezená má supremum.
Věta 0.194 (O dobrém uspořádání). Každou množinu lze dobře uspořádat.
Poznámka 0.55. V teorii ZF je věta o dobrém uspořádání ekvivalentní s axiomem výběru (AC).
Ordinální čísla jsou zobecnění přirozených čísel a udávají typy dobře uspořádaných množin. Pomocí ordinálních čísel pak lze nadefinovat kardinální čísla, což jsou speciální ordinální čísla, která měří mohutnosti množin. Ordinální čísla definujeme tak, aby byla dobře uspořádána relací , takže na nich budeme moci provádět takzvanou transfinitní indukci.
Definice 0.416. Třída je tranzitivní .
Definice 0.417 (Ordinální číslo). Množina je ordinální číslo
je tranzitivní,
relace je dobré ostré uspořádání na . z plyne
Třídu všech ordinální čísel značíme . (Jedná se o vlastní třídu).
Definice 0.418 (Kardinální čísla). Ordinální číslo nazveme kardinálním číslem, pokud není bijektivně ekvivalentní s žádným menším ordinálním číslem .
Třídu všech kardinálních čísel označíme . Tuto definici můžeme zapsat ve tvaru Kardinál je tedy nejmenší ordinál dané mohutnosti.
Definice 0.419 (Zobecnění von Neumannovou konstrukcí). Tedy každé je ordinálem.
Definice 0.420 (Následovník a limitní ordinál). Z transfinitní indukce máme dva typy ordinálů:
Následovník: , tedy k ordinálu přidáme jeden další prvek.
Limitní ordinál: Nemají přímého předchůdce, ale jsou ordinálem. Např. .
Poznámka 0.56 (Operace na ordinálech). Na ordinálech lze uplatnit následující operace:
Průnik: Průnikem libovolné neprázdné množiny ordinálů je ordinál. Průnikem je menší z nich. “V podstatě .”
Sjednocení: Sjednocením ordinálů je ordinál . “Funguje jako .”
Rozdíl množin: Většinou se poruší tranzitivita, tedy nemusí být ordinál.
Potenční množina: vyrobí skoro vždy množinu, která ordinálem není.
Izolované množiny (jednoprvková množina): Pokud ordinál zabalíme do složených závorek , zničíme tranzitivitu.
Primitivní funkce lze spočítat Riemannovským integrálem.↩︎
rovnost právě když jsou lineárně závislé↩︎
Věta je existenčního charakteru. Prakticky se jedná se o metodu na testování PD matic, slouží k tomu algoritmus.↩︎
Pokud i jsou sudá, pak platí .↩︎
Geometricky odpovídá tečně funkce v daném bodě a příslušné ose.↩︎
Pravděpodobnost, že daný vrchol odstraníme je ↩︎
Prvky budou hrany v grafu a množiny budou perfektní párování. Chceme nějak zvolit váhy a ukázat, že nám nějak jednoznačně identifikují nějakou z množin (tedy perfektních párování).↩︎
Vrcholově i hranově, pro -regulární grafy je to to samé; alternativně můžeme říct graf bez mostů a artikulací.↩︎